Wat is GPU-slicing?
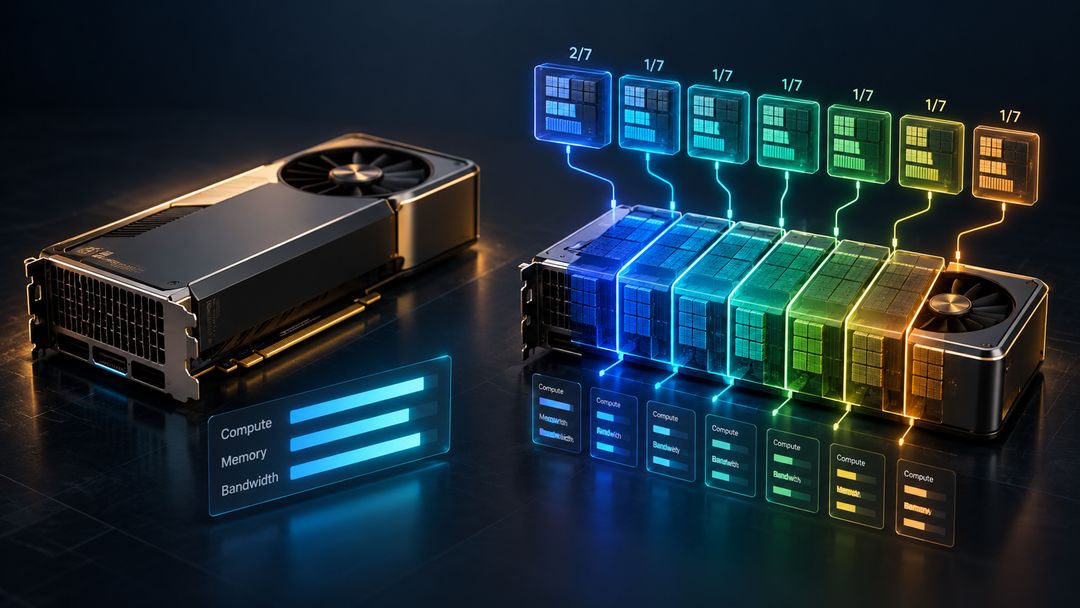
GPU slicing deelt een fysieke grafische kaart op in meerdere kleinere virtuele GPUs. Elke slice krijgt een vast deel van de VRAM en slechts een fractie van de rekenkernen en de geheugenbandbreedte van de kaart.
Bij MIG (Multi-Instance GPU) wordt dit op kaarten voor datacenters meestal toegepast. Een A100 of H200 kan worden opgesplitst in maximaal zeven instanties, waarbij elke instantie een vaste verdeling krijgt van streaming multiprocessors en geheugen. De naam verraadt het al: een profiel van “1g.10gb” is 1/7 van de chip met 10 GB VRAM.
Voor leveranciers is slicing een uitstekende manier om racks te vullen. Voor u betekent dat iets simpels: u huurt de naam van een grote GPU, maar slechts een deel van zijn vermogen.
⚡ Waarom slicing uw snelheid in de weg staat
Drie dingen verminderen wanneer een GPU gesliced wordt:
- CUDA-kernen. Een 2/7-slice van een A100 krijgt 1.792 van zijn kernen, niet 6.912.
- Geheugenbandbreedte. LLM-inferentie is bandbreedte-gebonden. Een slice krijgt een overeenkomstig deel van de geheugenbus, waardoor het aantal tokens per seconde sterk daalt.
- VRAM. U krijgt precies het geheugen van de slice. Grotere modellen, langere contexten en grotere batches passen gewoonweg niet.
Een volledige, kleinere kaart presteert vaak beter dan een geslicede, grotere. Een moderne Blackwell-kaart met alle zijn cores is sneller dan een bekende datacenter-GPU die in zeventiendeën is verdeeld.
📊 De vergelijking: klassieke datacenter-GPUs vs. Trooper.AI Blibs
Wij hebben typische aanbiedingen van Europese klassieke datacenters vergeleken met de overeenkomstige Trooper.AI Blibs. Elke Blib heeft minstens evenveel VRAM. Voor een eerlijke prijsvergelijking werd elke klassieke aanbieding geconfigureerd met precies dezelfde CPU-kernen, RAM en NVMe opslag als de Blib waarmee hij wordt vergeleken.
| Classische Data Center GPU | VRAM | CUDA-kernen (klassiek) | Trooper.AI Blib | VRAM | CUDA-kernen (Trooper.AI) | snelheid | Prijs |
|---|---|---|---|---|---|---|---|
| T4 – 1/4 deel | 4 GB | ~640 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Snelder | tot {{N}}56% goedkoper |
| T4 – halve machine | 8 GB | ~1,280 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Snelder | tot {{N}}64%{{/N}} goedkoper |
| T4 – volledig | 16 GB | 2,560 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Snelder | tot 74% goedkoper |
| A10 – 1/6 deel | 4 GB | ~1,536 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Snelder | tot 61% goedkoper |
| A10 – 1/3 slice | 8 GB | ~3,072 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Snelder | tot 70% goedkoper |
| A10 – ½-slice | 12 GB | ~4,608 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Snelder | tot 76% goedkoper |
| A10 – volledig | 24 GB | 9,216 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Snelder | tot {{N}}73%{{/N}} goedkoper |
| A100 – 1/7-slice | 10 GB | 896 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Snelder | tot {{N}}69%{{/N}} goedkoper |
| A100 – 2/7-slice | 20 GB | 1,792 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Snelder | tot {{N}}65%{{/N}} goedkoper |
| A100 – 3/7 deel | 40 GB | 2,688 | InfinityAI S1 · A100 (volle kaart) | 40 GB | 6,912 | Snelder | tot 61% goedkoper |
| A100 – volledige kaart | 80 GB | 6,272 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Snelder | tot {{N}}36%{{/N}} goedkoper |
| L40S – volledig | 48 GB | 18,176 | StellarAI L1 · RTX 4090 Pro | 48 GB | 16,384 | Snelder | tot {{N}}32%{{/N}} goedkoper |
| H200 – 1/7-slice | 20 GB | 2,048 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Snelder | tot {{N}}65%{{/N}} goedkoper |
| H200 – 2/7-slice | 40 GB | 4,096 | InfinityAI S1 · A100 (volle kaart) | 40 GB | 6,912 | Snelder | tot {{N}}67% goedkoper |
| H200 – 3/7 deel | 70 GB | 7,680 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Snelder | tot {{N}}36%{{/N}} goedkoper |
| H200 – volledig | 141 GB | 16,896 | HyperionAI M2 · 2× RTX Pro 6000 Blackwell | 192 GB | 48,128 | Gelijke snelheid | tot 40% goedkoper |
| RTX Pro 6000 – halve chip | 48 GB | ~12,032 | RabenAI S1 · RTX Pro 5000 Blackwell (volle kaart) | 48 GB | 14,080 | Snelder | tot 37% goedkoper |
Een gesliced GPU krijgt slechts een deel van de chip: minder CUDA cores, een overeenkomstig deel van de bandbreedte van het geheugen en een deel van de VRAM. Een Trooper.AI Blib krijgt altijd de volledige kaart.
🔍 Wat de tabel u vertelt
1. Een slice is geen GPU. Een «A100 met 20 GB» als 2/7-slice krijgt minder dan een derde van de chip. Onze Ranger S1 met een volledige RTX Pro 4000 Blackwell heeft vijf keer zoveel CUDA cores, meer VRAM en kost tot 65% minder.
2. Volledige kaarten winnen op bandbreedte. LLM-inferentie hangt af van geheugenbandbreedte – het leeft en sterft ermee. Een slice krijgt slechts een fractie daarvan, terwijl een volledige kaart alle bandbreedte krijgt. Daarom presteert een volledige A100 of RTX Pro 5000 vaak beter dan een veel "grotere" GPU die in stukken is verdeeld.
3. Blackwell verandert de berekeningen. Vijfdegeneratie Tensor Cores met ingebouwde FP4 en FP8 laten een enkele RTX Pro 6000 Blackwell sneller presteren dan zelfs een volledig toegewezen 80 GB A100 op moderne gekwantiseerde modellen, met 16 GB extra VRAM.
4. Zelfs de H200 verliest als het in slices wordt verdeeld. Een 3/7-slice heeft minder dan de helft van de streaming multiprocessors en de helft van de geheugenbandbreedte, en geen native FP4. Een volledige RTX Pro 6000 Blackwell presteert beter op moderne gekwantiseerde modellen, met 26 GB meer VRAM en tot 36% lagere kosten. Alleen een volledige, niet-gedeelde H200 komt overeen met twee HyperionAI kaarten, en die bieden u 192 GB in plaats van 141 GB.
5. De L40S is een eerlijke strijd, en wij winnen er nog steeds op. Tegenover een volledige L40S levert onze RTX 4090 Pro 48 GB hogere geheugenbandbreedte (ongeveer 1 TB/s versus 864 GB/s), wat cruciaal is voor LLM-inferentie, tegen een tot 32% lagere kostprijs.
💸 De verborgen kosten van ‘goedkope’ slices
De slice zelf lijkt vaak betaalbaar. De rekening niet. Klassieke datacenters factureren afzonderlijk voor elke vCore, elk gigabyte RAM en elk gigabyte opslag. Configureer een slice met voldoende RAM om uw model daadwerkelijk te laden en de prijs schiet snel omhoog.
Een realistische AI-workload heeft systeemgeheugen nodig dat minstens gelijk is aan de VRAM, voldoende CPU-kernen voor tokenisatie en gegevensladen, en snelle lokale opslag voor modelgewichten. Zodra u die toevoegt, is een gesliced GPU zelden de goedkoopste optie.
| Kostenfactor | Klassieke data-centerpartitie | Trooper.AI Blib |
|---|---|---|
| GPU | Aandeel van een kaart | Volledige kaart, bare-metal |
| CPU-kernen | Gerekend per vCore | Inbegrepen, exclusief toegewezen |
| RAM | In rekening gebracht per GB | Inbegrepen, exclusief toegewezen |
| Opslag | Vaak netwerkgebonden, in rekening gebracht per GB | Lokale NVMe tot 7,5 GB/s, inbegrepen |
| Opstartkosten | Gebruikelijk bij bare-metal aanbiedingen | Geen |
| Facturering | Vaak maandelijks of op lange termijn | Uurlijks, wekelijks of maandelijks |
🇪🇺 Hoe Trooper.AI u de volledige GPU geeft
Trooper.AI verhuurt EU-gestuurde GPU-servers, geëxploiteerd vanuit Duitsland, met volledige, bare-metal GPUs in elke Blib. Geen slicing, geen gedeelde silicon, geen hinderlijke buren op uw kaart. Van een RTX A4000 tot vier RTX Pro 6000 Blackwell-kaarten met 384 GB VRAM, krijgt u altijd de complete GPU.
Belangrijkste voordelen zijn:
- ✅ 100% bare-metal GPU, CPU en RAM
- ✅ Lokale NVMe opslag met tot 7,5 GB/s
- ✅ 99,6% beschikbaarheid SLA voor zakelijke klanten
- ✅ EU-gehost, GDPR DPA met één klik ondertekend
- ✅ Volledige root-toegang en éénklik-AI-sjablonen (vLLM, OpenWebUI, ComfyUI en meer)
- ✅ Uur-, week- of maandelijkse facturering, inclusief gereserveerde Blackwell-capaciteit
Configure uw volledige GPU-machine nu →
Veelgestelde vragen
Wat is een geslicede GPU?
Een geslicede GPU is een deel van een fysieke grafische kaart, meestal gemaakt met MIG of vGPU-profielen. U krijgt een vast aandeel van de VRAM en slechts een fractie van de CUDA-kernen en geheugenbandbreedte.
Is een geslicede A100 of H200 sneller dan een volledige moderne GPU?
Meestal niet. Een 1/7 of 2/7-slice heeft slechts een klein deel van de originele chip. Een volledige, moderne kaart zoals de RTX Pro 4000 of RTX Pro 6000 Blackwell levert meer CUDA-cores, meer bandbreedte en ingebouwde FP4/FP8-ondersteuning.
Wanneer heeft een slice zin?
Voor zeer kleine, piekvraag-inferentietaken of virtuele bureaus waar een fractie van een GPU voldoende is. Voor LLM-inferentie, fine-tuning of beeldgeneratie is een volledige kaart de betere keuze.
Beïnvloedt GPU-slicing de prestaties van een LLM?
Ja, aanzienlijk. LLM-inferentie wordt beperkt door de geheugenbandbreedte, en een slice krijgt slechts een fractie daarvan toegekend. Tokens per seconde dalen ongeveer evenredig met de grootte van de slice.
Wordt uw Trooper.AI GPU ooit gedeeld?
Nee. Elke Blib krijgt volledige, gedediceerde bare-metal GPUs, CPU-kernen en RAM. Niets wordt gesliced of gedeeld met andere klanten.
Wat is de beste eerste stap?
Controleer hoeveel VRAM uw model nodig heeft, kies vervolgens de kleinste full-card Blib die past. U krijgt de hele GPU en kunt later upgraden zonder opnieuw te installeren.
Laatst bijgewerkt: september 2026. Vergelijking gebaseerd op openbaar gepubliceerde aanbiedingen van Europese klassieke datacenterproviders (september 2026), geconfigureerd met identieke CPU, RAM en opslag als de overeenkomstige Trooper.AI Blib. Maandelijkse facturering. Snelheidsbeoordelingen zijn onze inschatting op basis van CUDA-kernen, geheugenbandbreedte, architectuur en onze eigen TAIFlops-benchmarks.
Waar wacht je nog op?
Huur vandaag nog uw eigen GPU-server en begin met het bouwen van geweldige AI-applicaties! Trooper.AI GPU-servers zijn gebouwd met uitsluitend gerecyclede high-end technologie van de afgelopen jaren, ontworpen om u de beste prestaties, beveiliging en betrouwbaarheid te bieden voor al uw AI-behoeften.
Huur een GPU Server voor AI
EU-locatie · Hoge privacy · Geweldige prestaties · Beste ondersteuning