Was ist GPU-Slicing?
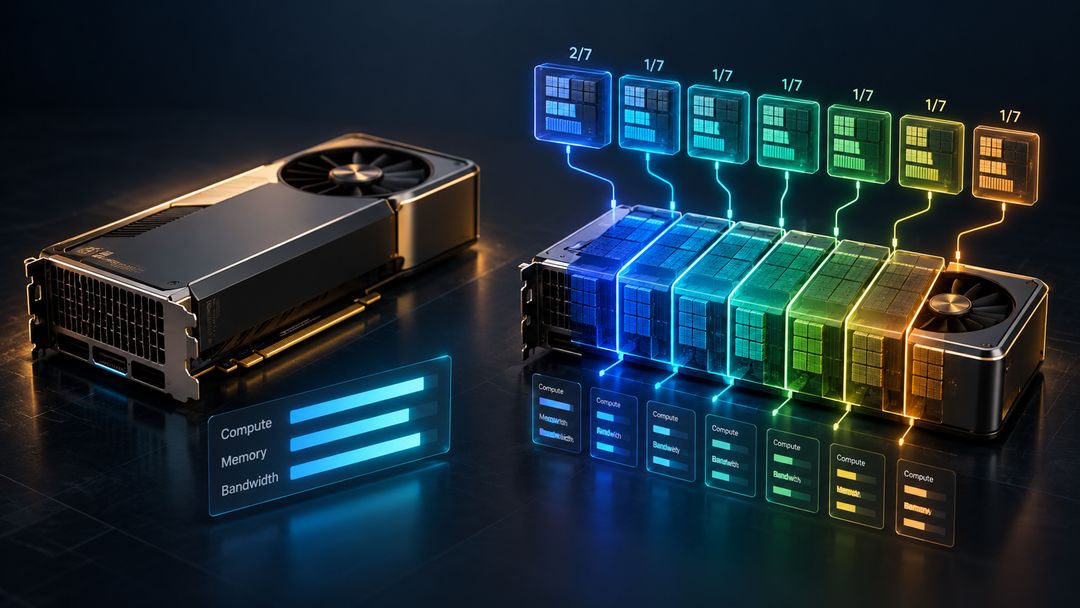
GPU-Slicing teilt eine physische Grafikkarte in mehrere kleinere virtuelle GPUs auf. Jede Scheibe erhält einen festen Anteil des VRAM sowie nur einen Bruchteil der Recheneinheiten der Karte und der Speicherbandbreite.
Bei Datenzentrums-GPUs wird dies üblicherweise mit MIG (Multi-Instance GPU) durchgeführt. Eine A100 oder H200 lässt sich in bis zu sieben Instanzen aufteilen, wobei jede eine feste Partition der Streaming-Multiprozessoren und des Speichers erhält. Der Name verrät es: ein „1g.10gb“-Profil entspricht 1/7 des Chips mit 10 GB VRAM.
Für Anbieter ist Slicing eine großartige Möglichkeit, Racks auszulasten. Für Sie bedeutet das etwas Einfaches: Sie mieten den Namen einer großen GPU, erhalten aber nur einen Teil ihrer Leistung.
⚡ Warum Slicing Ihnen Geschwindigkeit kostet
Drei Dinge schrumpfen, wenn eine GPU gesliced wird:
- CUDA-Kerne. Ein 2/7-Slice einer A100 erhält 1.792 seiner Kerne – nicht 6.912.
- Speicherbandbreite. Die Inferenz von Sprachmodellen (LLMs) ist bandbreitengebunden. Eine Scheibe erhält einen entsprechenden Bruchteil des Speicherbusses, wodurch die Tokens pro Sekunde stark sinken.
- VRAM. Sie erhalten genau den Speicher der Slice. Größere Modelle, längere Kontexte und größere Batches passen einfach nicht.
Eine vollständige, kleinere Karte schlägt oft eine geschnittene, größere. Eine moderne Blackwell-Karte mit allen ihren Kernen ist schneller als ein berühmter Data-Center-GPU, der in Siebtel aufgeteilt wurde.
📊 Der Vergleich: Klassische Rechenzentrum-GPUs vs. Trooper.AI Blibs
Wir haben typische Angebote europäischer klassischer Rechenzentren mit den passenden Trooper.AI Blibs verglichen. Jeder Blib verfügt über mindestens denselben VRAM. Für einen fairen Preisvergleich wurde jedes klassische Angebot mit genau denselben CPU-Kernen, RAM und NVMe-Speicher wie der jeweilige Blib konfiguriert.
| Klassische Data-Center-GPU | VRAM | CUDA-Kerne (klassisch) | Trooper.AI Blib | VRAM | CUDA-Kerne (Trooper.AI) | Geschwindigkeit | Preis |
|---|---|---|---|---|---|---|---|
| T4 – 1/4-Slice | 4 GB | ~640 | Trooper Explorer S1 · RTX A4000 | 16 GB | 6,144 | Schneller | bis zu 56 % günstiger |
| T4 – halbe Scheibe | 8 GB | ~1,280 | Trooper Explorer S1 · RTX A4000 | 16 GB | 6,144 | Schneller | bis zu 64 % günstiger |
| T4 – vollständig | 16 GB | 2,560 | Trooper Explorer S1 · RTX A4000 | 16 GB | 6,144 | Schneller | bis zu 74 % günstiger |
| A10 – 1/6-Slice | 4 GB | ~1,536 | Trooper Explorer S1 · RTX A4000 | 16 GB | 6,144 | Schneller | bis zu 61 % günstiger |
| A10 – 1/3-Slice | 8 GB | ~3,072 | Trooper Explorer S1 · RTX A4000 | 16 GB | 6,144 | Schneller | bis zu 70 % günstiger |
| A10 – 1/2-Slice | 12 GB | ~4,608 | Trooper Explorer S1 · RTX A4000 | 16 GB | 6,144 | Schneller | bis zu 76 % günstiger |
| A10 – vollständig | 24 GB | 9,216 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Schneller | bis zu 73 % günstiger |
| A100 – 1/7-Slice | 10 GB | 896 | Trooper Explorer S1 · RTX A4000 | 16 GB | 6,144 | Schneller | bis zu 69 % günstiger |
| A100 – 2/7-Slice | 20 GB | 1,792 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Schneller | bis zu 65 % günstiger |
| A100 – 3/7-Slice | 40 GB | 2,688 | InfinityAI S1 · A100 (volle Karte) | 40 GB | 6,912 | Schneller | bis zu 61 % günstiger |
| A100 – 7/7-Slice | 80 GB | 6,272 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Schneller | bis zu 36 % günstiger |
| L40S – voll | 48 GB | 18,176 | StellarAI L1 · RTX 4090 Pro | 48 GB | 16,384 | Schneller | bis zu 32 % günstiger |
| H200 – 1/7-Slice | 20 GB | 2,048 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Schneller | bis zu 65 % günstiger |
| H200 – 2/7-Slice | 40 GB | 4,096 | InfinityAI S1 · A100 (volle Karte) | 40 GB | 6,912 | Schneller | bis zu 67 % günstiger |
| H200 – 3/7-Slice | 70 GB | 7,680 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Schneller | bis zu 36 % günstiger |
| H200 – vollständig | 141 GB | 16,896 | HyperionAI M2 · 2× RTX Pro 6000 Blackwell | 192 GB | 48,128 | Gleiche Geschwindigkeit | bis zu 40 % günstiger |
| RTX Pro 6000 – 1/2-Slice | 48 GB | ~12,032 | RabenAI S1 · RTX Pro 5000 Blackwell (volle Karte) | 48 GB | 14,080 | Schneller | bis zu 37 % günstiger |
Eine geschnittene GPU erhält nur einen Bruchteil des Chips: weniger CUDA-Cores, eine entsprechende Fraktion der Speicherbandbreite sowie einen Anteil am VRAM. Ein Trooper.AI Blib erhält immer die volle Karte.
🔍 Was die Tabelle Ihnen zeigt
1. Ein Slice ist keine GPU. Ein „A100 mit 20 GB“ als 2/7-Slice erhält weniger als ein Drittel der Karte. Unser Ranger S1 mit einer vollen RTX Pro 4000 Blackwell bietet fünfmal so viele CUDA-Kerne, mehr VRAM und ist bis zu 65 % günstiger.
2. Volle Karten gewinnen bei Bandbreite. Die Inferenz von Sprachmodellen (LLMs) hängt maßgeblich von der Speicherbandbreite ab. Eine Slice erhält nur einen Bruchteil davon, eine volle Karte hingegen die gesamte Bandbreite. Deshalb übertrifft ein voller A100 oder RTX Pro 5000 regelmäßig eine scheinbar „größere“ GPU, die in Stücke zerteilt wurde.
3. Blackwell ändert die Rechnung. Fünftgenerations-Tensor-Cores mit nativem FP4 und FP8 ermöglichen es einer einzelnen RTX Pro 6000 Blackwell, selbst eine voll ausgelastete 80-GB-A100 auf modernen quantisierten Modellen zu übertreffen – bei 16 GB mehr VRAM.
4. Selbst die H200 verliert, wenn sie gesliced wird. Eine 3/7-Slice hat weniger als die Hälfte der Streaming-Multiprocessoren und die Hälfte des Speicherbandbreiten, sowie keinen nativen FP4. Eine volle RTX Pro 6000 Blackwell schlägt sie bei modernen quantisierten Modellen, mit 26 GB mehr VRAM und bis zu 36 % geringeren Kosten. Nur die volle, ungesliced H200 ist mit zwei HyperionAI-Karten vergleichbar, und diese bieten Ihnen 192 GB statt 141 GB.
5. Der L40S ist ein fairer Vergleich, und wir gewinnen trotzdem. Gegen einen vollen L40S liefert unsere RTX 4090 Pro mit 48 GB höhere Speicherbandbreite (ca. 1 TB/s gegenüber 864 GB/s), was für die LLM-Inferenz entscheidend ist – und das bei bis zu 32 % geringeren Kosten.
💸 Die versteckten Kosten von „günstigen“ Slices
Die Scheibe selbst wirkt oft günstig. Die Rechnung sieht anders aus. Klassische Rechenzentren berechnen separat für jeden vCore, jedes Gigabyte RAM und jedes Gigabyte Speicherplatz. Konfigurieren Sie eine Scheibe mit ausreichend RAM, um Ihr Modell tatsächlich zu laden, und der Preis steigt schnell an.
Eine realistische KI-Arbeitslast benötigt System-RAM mindestens gleich viel wie die VRAM, ausreichend CPU-Kerne für Tokenisierung und Datenladen sowie schnellen lokalen Speicher für Modellgewichte. Sobald Sie diese hinzufügen, ist eine geschnittene GPU selten die günstige Option.
| Kostenfaktor | Klassische Data-Center-Slice | Trooper.AI Blib |
|---|---|---|
| GPU | Anteil einer Grafikkarte | Vollständige Karte, bare-metal |
| CPU-Kerne | Abgerechnet pro vCore | Enthalten, dediziert |
| RAM | Pro GB abgerechnet | Enthalten, dediziert |
| Speicher | Häufig netzwerkgebunden, pro GB abgerechnet | Lokales NVMe bis zu 7,5 GB/s, inklusive |
| Einrichtungsgebühren | Üblich bei bare-metal-Angeboten | Keine |
| Abrechnung | Häufig monatlich oder auf lange Sicht | Stündlich, wöchentlich oder monatlich |
🇪🇺 Wie Trooper.AI Ihnen die volle GPU gibt
Trooper.AI vermietet EU-gehostete GPU-Server, betrieben aus Deutschland, mit vollständigen Bare-Metal-GPUs in jedem Blib. Kein Slicing, kein geteiltes Silizium, keine lästigen Nachbarn auf Ihrer Karte. Von einer RTX A4000 bis zu vier RTX Pro 6000 Blackwell-Karten mit 384 GB VRAM erhalten Sie stets die vollständige GPU.
Wichtige Vorteile umfassen:
- ✅ 100 % reine Bare-Metal-GPU, CPU und RAM
- ✅ Lokale NVMe-Speicherung mit bis zu 7,5 GB/s
- ✅ 99,6 % Verfügbarkeit SLA für Geschäftskunden
- ✅ EU-gehostet, GDPR DPA mit einem Klick unterzeichnet
- ✅ Volle Root-Zugriff und AI-Vorlagen mit einem Klick (vLLM, OpenWebUI, ComfyUI und mehr)
- ✅ Stundengerechnete, wöchentliche oder monatliche Abrechnung, inklusive reservierter Blackwell-Kapazität
Konfigurieren Sie Ihren vollen GPU-Server jetzt →
Häufig gestellte Fragen
Was ist eine geschnittene GPU?
Eine geslicete GPU ist ein Bruchteil einer physischen Grafikkarte, typischerweise mit MIG oder vGPU-Profilen erstellt. Sie erhalten einen festen Anteil des VRAM sowie nur einen Bruchteil der CUDA-Kerne und des Speicherbandbreiten.
Ist ein gesliceter A100 oder H200 schneller als eine volle moderne GPU?
Meistens nicht. Eine 1/7- oder 2/7-Scheibe besitzt nur einen kleinen Teil des ursprünglichen Chips. Eine volle, moderne Karte wie der RTX Pro 4000 oder RTX Pro 6000 Blackwell bietet mehr CUDA-Kerne, mehr Bandbreite und nativen FP4/FP8-Support.
Wann lohnt sich ein Slice?
Für sehr kleine, kurzzeitige Inferenzaufgaben oder virtuelle Desktops, bei denen ein Bruchteil einer GPU ausreicht, kann ein Slice sinnvoll sein. Für LLM-Inferenz, Feinabstimmung oder Bildgenerierung ist jedoch eine volle Karte die bessere Wahl.
Beeinträchtigt GPU-Slicing die LLM-Leistung?
Ja, deutlich. Die LLM-Inferenz ist durch den Speicherbandbreiten begrenzt, und eine Slice erhält nur einen Bruchteil davon. Tokens pro Sekunde sinken etwa im Verhältnis zur Slice-Größe.
Werden Trooper.AI-GPUs jemals geteilt?
Nein. Jeder Blib erhält volle, dedizierte Bare-Metal-GPUs, CPU-Kerne und RAM. Nichts wird gesliced oder mit anderen Kunden geteilt.
Was ist der beste erste Schritt?
Prüfen Sie, wie viel VRAM Ihr Modell benötigt, und wählen Sie dann den kleinsten Vollkarten-Blib aus, der passt. Sie erhalten die gesamte GPU und können später ohne Neuinstallation aufrüsten.
Zuletzt aktualisiert: September 2026. Vergleich basierend auf öffentlich gelisteten Angeboten europäischer klassischer Rechenzentrumsanbieter (September 2026), konfiguriert mit identischem CPU, RAM und Speicher wie der passende Trooper.AI Blib. Monatliche Abrechnung. Geschwindigkeitsbewertungen sind unsere Einschätzung auf Basis von CUDA-Kernen, Speicherbandbreite, Architektur und unseren eigenen TAIFlops-Benchmarks.
Worauf warten Sie noch?
Mieten Sie noch heute Ihren eigenen GPU-Server und beginnen Sie mit dem Erstellen erstaunlicher KI-Anwendungen! Die Trooper.AI GPU-Server basieren auf rein wiederaufbereiteten High-End-Technologien der letzten Jahre und wurden entwickelt, um Ihnen die beste Leistung, Sicherheit und Zuverlässigkeit für alle Ihre KI-Bedürfnisse zu bieten.
Mieten Sie einen GPU-Server für KI
EU-Standort · Hohe Privatsphäre · Hervorragende Leistung · Bester Support