Egal, ob Sie bereits einen GPU-Server betreiben und ein Modell mit vLLM darauf ausführen möchten oder neu sind und sich in die private, in der EU gehostete LLM-Inferenz einarbeiten wollen – dieser One-Click-Private-LLM-Dienst ist für Sie.
- Ein-Klick-Deployment: Klicken Sie auf Start (stündlich oder monatlich), um einen mit vLLM vorinstallierten GPU-Server zu starten – basierend auf der exakt getesteten Konfiguration für dieses Modell.
- Nur was verfügbar ist: Der Start wird nur aktiviert, wenn die beste GPU tatsächlich frei zum Bereitstellen verfügbar ist.
- Qualität zuerst prüfen: öffnen Sie Antwortqualität anzeigen, um echte Beispielantworten pro Testkategorie zu lesen, bevor Sie sich entscheiden.
| Modell | Kontext | Parallel-T/S | Einzelne Tokens/Sekunde | Stündlich | Monatlich | Konfiguration |
|---|---|---|---|---|---|---|
| Llama 3.3 70B 4-bit Perfect on sparbox.m2.nl-mst | 12,288 | 68 | 35 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
| Qwen3 30B 4-bit Perfect on infinityai.m1.de-nue | 84,992 | 838 | 153 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen3.6 27B 4-bit Perfect on infinityai.m1.de-nue | 58,368 | 402 | 58 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen3.6 35B 4-bit Perfect on infinityai.m1.de-nue | 52,224 | 96 | 14 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Gemma 4 31B 4-bit Perfect on sparbox.m2.nl-mst | 17,408 | 390 | 62 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
| Gemma 4 E2B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 76,800 | 914 | 133 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 117,760 +52% | 1,160 +27% | 184 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Gemma 4 E4B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 30,720 | 538 | 70 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 95,232 +205% | 737 +37% | 104 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Granite 4.1 8B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 18,432 | 339 | 46 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 76,800 +300% | 556 +64% | 76 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Llama 3.1 8B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 23,552 | 380 | 51 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 95,232 +300% | 621 +64% | 86 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Phi 4 Perfect on infinityai.m1.de-nue | 14,336 | 339 | 44 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Phi 4 multimodal Perfect on infinityai.m1.de-nue | 105,472 | 977 | 132 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Ministral 3 14B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 20,480 | 429 | 56 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 84,992 +300% | 623 +45% | 89 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Ministral 3 3B Perfect on sparbox.s1.nl-mst | 84,992 | 1,218 | 164 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| Mistral 7B Perfect on sparbox.s1.nl-mst | 28,672 | 399 | 53 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| Llama 3.1 8B 8-bit Perfect on infinityai.m1.de-nue | 117,760 | 889 | 115 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| GPT OSS 20B Perfect on infinityai.m1.de-nue | 117,760 | 685 | 201 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Ornith 1.0 9B 4-bit Perfect on ranger.s1.nl-mst | 52,224 | 78 | 59 | €0.43/h | €232.00/mo | ranger.s1.nl-mst |
| Qwen3 Coder 30B 4-bit Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 25,600 | 886 | 170 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 84,992 +224% | 949 +7% | 167 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 VL 32B 4-bit Perfect on infinityai.m1.de-nue | 28,672 | 421 | 56 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen2.5 32B 4-bit Perfect on infinityai.m1.de-nue | 28,672 | 429 | 57 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen2.5 7B Perfect on sparbox.s1.nl-mst | 28,672 | 400 | 51 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| Qwen3 14B Perfect on infinityai.m1.de-nue | 25,600 | 342 | 44 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen3 32B 8-bit Perfect on infinityai.m1.de-nue More context, higher speed on sparbox.m2.nl-mst | 7,168 | 70 | 35 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| 18,432 +162% | 297 +326% | 42 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 4B Perfect on sparbox.s1.nl-mst | 36,864 | 627 | 85 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| Qwen3 4B (2507) Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 58,368 | 626 | 84 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 117,760 +100% | 895 +43% | 121 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 8B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 23,552 | 379 | 49 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 36,864 +54% | 604 +59% | 83 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 Coder 30B 8-bit Perfect on infinityai.m1.de-nue More context on sparbox.m2.nl-mst | 25,600 | 777 | 136 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| 41,984 +62% | 812 | 153 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 VL 32B 8-bit Perfect on sparbox.m2.nl-mst | 15,360 | 294 | 41 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
| Qwen3 VL 4B Perfect on novatesla.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 69,632 | 436 | 68 | €0.34/h | €182.00/mo | novatesla.m1.nl-mst |
| 117,760 +69% | 874 +101% | 119 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3.5 9B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 20,480 | 115 | 17 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 95,232 +344% | 558 +384% | 82 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3.6 27B 8-bit Perfect on infinityai.m1.de-nue | 23,552 | 291 | 41 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Gemma 4 31B 8-bit Perfect on sparbox.m2.nl-mst | 8,192 | 286 | 43 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
Kontext = maximal nutzbare Kontextfenstergröße. Parallel/Einzeln = Tokens/Sekunde. Die Preise spiegeln das beste Preis-Leistungs-Verhältnis pro Modell mit der besten GPU wider. Die Kosten sind im Voraus zu entrichten; Sie behalten vollen Root-Zugriff.
Einfach nur den GPU-Server?
Hier müssen Sie kein Modell auswählen – bestellen Sie stattdessen einen reinen GPU-Server und führen Sie darauf aus, was immer Ihnen gefällt, mit vollem Root-Zugriff.
GPU Server mietenIhr vLLM-Dashboard ist direkt nach dem Deployment bereit
Sobald Sie auf Start klicken, ist Ihr privates Modell innerhalb weniger Sekunden über eine mit OpenAI kompatiblen Schnittstelle verfügbar – überwachen Sie Durchsatz, Kontextnutzung und Anfragen direkt von Ihrem eigenen Dashboard.
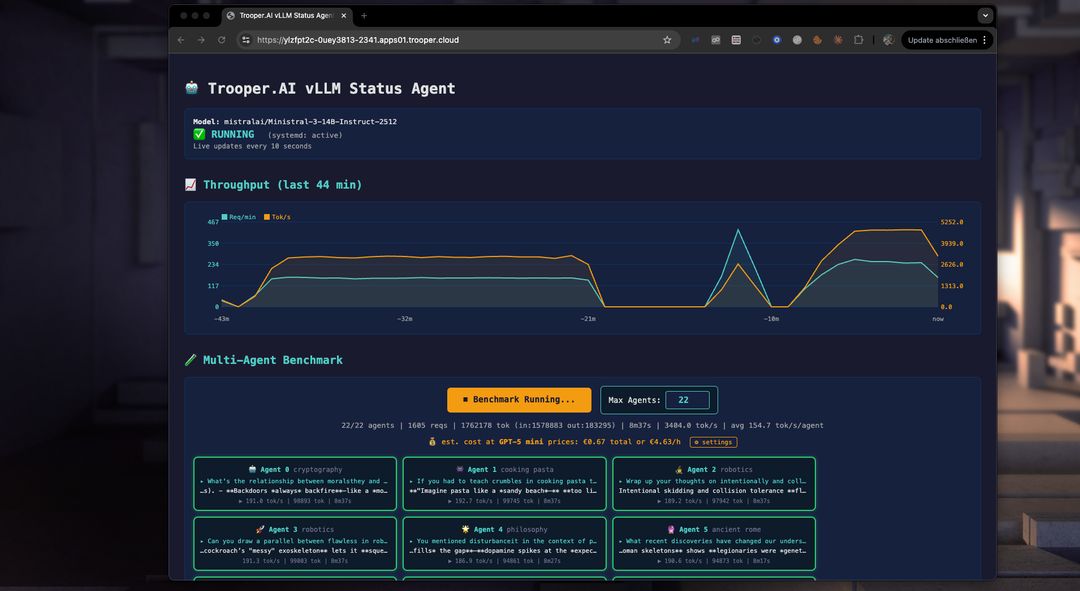
Die Top 10 Funktionen Ihres privaten LLM-GPU-Servers
- Ein-Klick-vLLM-Deploy — Ihr Modell startet mit der exakt getesteten Konfiguration (Kontextlänge, Parallelität, Startflags)
- mit OpenAI kompatibler API sofort einsatzbereit – richten Sie Ihre bestehende SDK direkt auf Ihr privates Endpunkt.
- Vollständig private Inferenz — Ihre Prompts und Daten verlassen niemals Ihren eigenen Server
- Tier-III (NL/FR) & ISO 27001 (DE) EU-Rechenzentren 🇪🇺, DS-GVO-konform mit einem Klick auf DPA/AVV
- Volle Root-SSH-Zugriffsrechte — Modelle nachtrainieren, austauschen oder zusätzliche KI-Software neben vLLM installieren
- Professionell getestete GPU-Treiber & aktuelles CUDA – keine Treiber-/Versionsprobleme
- 100 % reine Bare-Metal-GPU-Leistung – die Tokens/Sek., die Sie im Benchmark sehen, sind exakt die Tokens/Sek., die Sie erhalten
- Kostenloses SSL 🔒 auf Ihrem Endpunkt (HTTPS & WSS) inklusive einer individuell einstellbaren Netzwerkebenen-Firewall
- Persistente Speicherung mit Pause/Einfrieren – behalten Sie Ihr Modell und die Gewichte, zahlen Sie nur bei Nutzung
- 🚀 Jederzeit Hardware aufrüsten — Wechseln zu einer leistungsstärkeren GPU für größeren Kontext oder größere Modelle ohne Neuinstallation
Verwalteter GPU-Server mit vorinstalliertem vLLM
Trooper.AI stellt Ihnen einen verwalteten GPU-Server mit vorinstalliertem vLLM bereit, der jeden offenen Large-Language-Modell über eine schnelle, OpenAI-kompatible API bedienen kann. Statt Stunden damit zu verbringen, eine GPU auszuwählen, CUDA-Treiber zu installieren oder vLLM zu kompilieren sowie Launch-Flags anzupassen, wählen Sie einfach ein Modell oben aus und klicken auf Starten. Innerhalb weniger Minuten erhalten Sie einen dedizierten, in der EU gehosteten GPU-Server mit bereits laufendem vLLM – inklusive der exakt von uns für dieses Modell optimierten Konfiguration wie Kontextlänge, Parallelität und Commandline-Argumente.
Warum ein vorkonfigurierter vLLM-Server?
vLLM ist der branchenübliche Hochleistungs-Inference-Engine für hohe Durchsatzraten, doch die Produktionsbereitschaft erfordert präzise Abstimmung: Kompatibilität von Treibern und CUDA-Versionen sowie die Auswahl von --max-num-batched-tokens, --max-num-seqs und des passenden Kontextfensters für Ihren GPU-Arbeitsspeicher (VRAM). Zudem muss sichergestellt werden, dass das Modell korrekt lädt. Unser verwalteter GPU-Server mit vorinstalliertem vLLM übernimmt diese Arbeit für Sie. Jede auf dieser Seite vorgestellte Konfiguration basiert direkt auf automatisierten Benchmark-Messungen auf echter Hardware – Ihr bereitgestellter Server verhält sich somit exakt wie im Testlauf, ohne Umwege oder Fehlversuche.
Exklusiv für Sie – EU-beherbergt und Ihr Eigentum
Jeder Server läuft auf Bare-Metal-GPUs in nach ISO/IEC 27001 zertifizierten, datenschutzkonformen deutschen Rechenzentren gemäß DSGVO. Sie erhalten vollen Root-SSH-Zugriff, eine persistente Maschine sowie einen privaten Endpunkt – Ihre Prompts und Daten verlassen niemals Ihren Server. Da es sich um einen vollständigen GPU-Server (keine Shared-Inference-Umgebung) handelt, können Sie zusätzlich KI-Software installieren, Modelle feinabstimmen oder Bild- und Audiomodelle neben Ihrem Sprachmodell betreiben.
Transparente Preis-Leistung
Für jedes Modell zeigen wir Ihnen die GPU mit dem besten Preis-Leistungs-Verhältnis, inklusive ehrlicher stündlicher und monatlicher Preise. Sie können sich vor der Bereitstellung reale Antwortbeispiele pro Modell über Antwortqualität anzeigen ansehen, sodass Sie sowohl Geschwindigkeit als auch die Qualität der Antworten kennen, für die Sie zahlen. Bezahlen Sie stundenweise zum Experimentieren oder monatlich für den Produktiveinsatz – ein verwalteter GPU-Server mit vorkonfiguriertem vLLM, der sich Ihren Anforderungen anpasst.
Ihr eigener privater LLM-GPU-Server
Ein dedizierter privater LLM-GPU-Server gibt Ihnen die volle Maschine: vollständigen Root-Zugriff, eine private OpenAI-kompatible Schnittstelle, unbegrenzte Anfragen zu einem pauschalen Vorauszahlungstarif sowie die Freiheit zum Feintuning, Modellwechsel oder Ausführung von Bild- und Audioaufgaben neben Ihrer KI-Modellierung. Da der GPU Ihnen gehört, sind Durchsatz und Kontextlänge vorhersehbar und Ihre Abfragen verlassen niemals Ihren Server – ideal für gleichmäßigen Traffic und strenge Datenschutzanforderungen.
Wählen Sie ein Modell aus der Matrix oben aus und klicken Sie auf Start: Innerhalb weniger Minuten erhalten Sie einen in der EU gehosteten GPU-Server mit bereits laufendem vLLM in der exakt benchmarkten Konfiguration – inklusive Context-Länge, Parallelität und Launch-Flags. Bezahlen Sie stündlich zum Experimentieren oder monatlich für den Produktivbetrieb und rüsten Sie jederzeit auf eine größere GPU auf, um mehr Kontext oder Modelle zu nutzen, ohne neu installieren zu müssen.
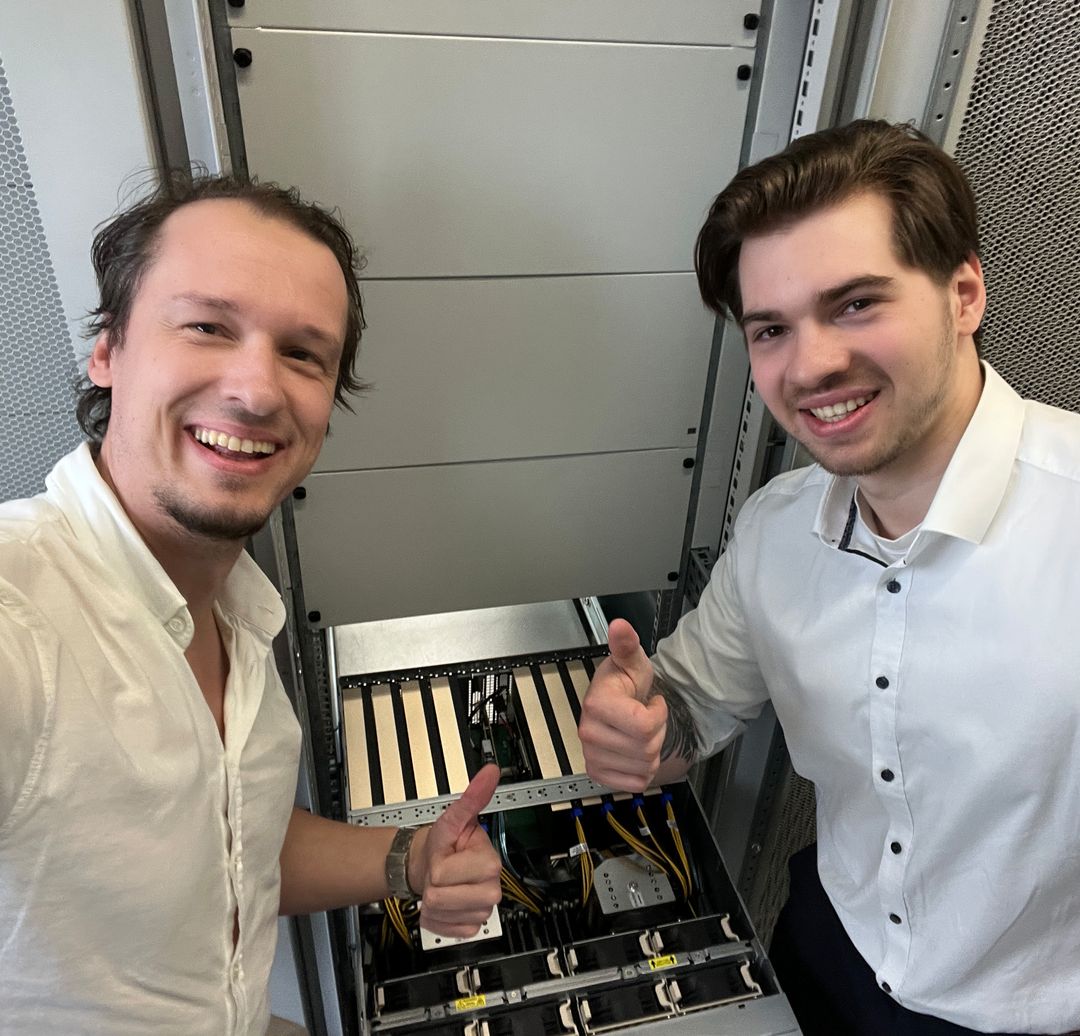
Zuverlässige Hardware – Entwickelt von Fachleuten
Hinter jedem privaten LLM-GPU-Server steht hochwertige, aufbereitete Hardware, die von unserem eigenen Team gewartet wird. Hier sind Markus und Jaimie dabei, einen NVIDIA-A100-Cluster in einem unserer nach ISO/IEC 27001 zertifizierten Rechenzentren mit Colocation-Dienstleistung in Deutschland zu installieren – dieselbe Klasse an GPU-Servern, wie Sie sie über diese Seite bereitstellen können. Wir recyceln Hochleistungs-Komponenten zu optimierten Inferenz-Systemen um, verlängern damit die Lebensdauer der Hardware und reduzieren gleichzeitig Elektroschrott. Wir verkaufen keine fremde Kapazität weiter; wir besitzen und betreiben unsere eigene Hardware in Rechenzentren mit Colocation-Diensten in Deutschland und den Niederlanden. Dadurch können wir Leistung, Sicherheit sowie Datensouveränität auf jeder Ebene des Systems garantieren.
Kompatibel mit der OpenAI Chat Completions API – Migrieren Sie Ihre KI-Infrastruktur in Minuten
Ihr privater vLLM-Server stellt ein Endpunkt bereit, der zu 100 % mit dem Format der OpenAI Chat Completions API kompatibel ist (/v1/chat/completions). Falls Ihre Anwendung bereits den OpenAI SDK – sei es für Python, Node.js oder jeden anderen HTTP-Client – nutzt, ist der Wechsel zu Ihrem eigenen Server eine Zeilenänderung: Aktualisieren Sie einfach die Basis-URL und den API-Schlüssel. Sie erhalten dasselbe Anfrage- und Antwortschema sowie volle Unterstützung für Streaming, JSON-Modus, Function Calling und multimodale Eingaben. Keine Neuschreibung des Codes, keine neuen Abstraktionen, kein Anbieter-Lock-in – Ihre Integration bleibt portabel und Sie behalten die Kontrolle.
Suche nach einer in Europa gehosteten Alternative zur OpenAI-API? Ein privater LLM-GPU-Server bietet Ihnen äquivalente Chat-Completion-API-Funktionalität mit EU-Datensitz, einem pauschalen Vorabpreis sowie voller Eigentümerschaft der Maschine.
Funktioniert mit Ihren Bestehenden Werkzeugen
Weil Ihr Server die OpenAI Chat Completions API unterstützt, können Sie ihn nahtlos in jedes beliebige KI-Tool, jede IDE oder jeden Automatisierungsplattform einbinden – einfach die Basis-URL auf Ihren eigenen Endpunkt verweisen und Ihren Schlüssel hinzufügen. Einige bekannte Beispiele:
… und viele weitere — jede App, jeder Agent oder jedes SDK, das eine mit OpenAI kompatible Schnittstelle unterstützt, funktioniert sofort einsatzbereit.