Qu’est-ce que le GPU slicing ?
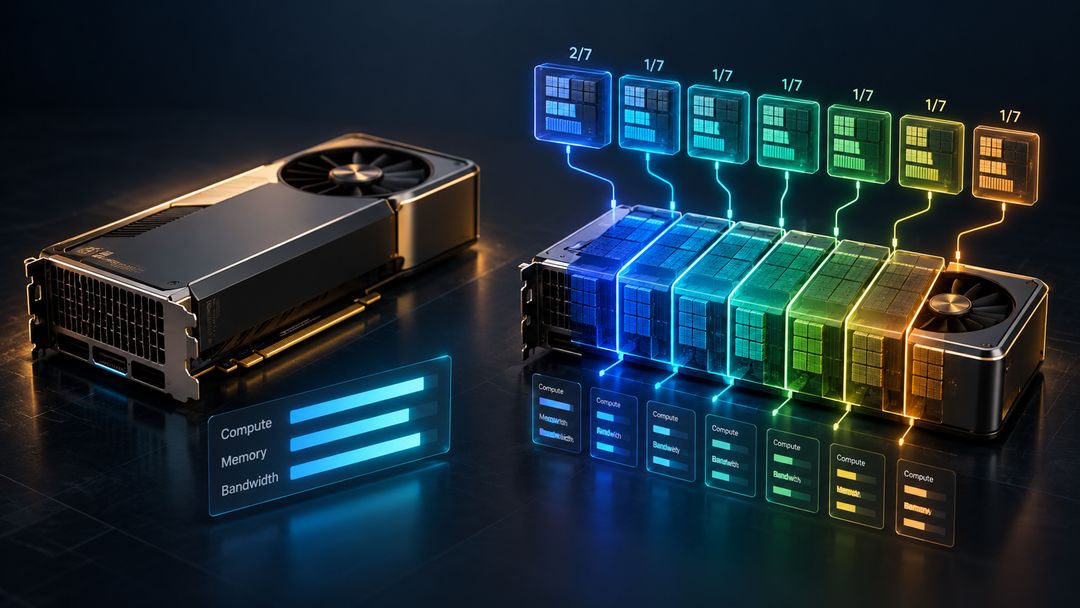
Le GPU slicing divise une carte graphique physique en plusieurs GPU virtuels plus petits. Chaque tranche obtient une part fixe de la VRAM et seulement une fraction des unités de calcul ainsi que de la bande passante mémoire de la carte.
Sur les cartes de centre de données, cela se fait généralement avec MIG (Multi-Instance GPU). Un A100 ou H200 peut être divisé en jusqu’à sept instances, et chacune reçoit une partition fixe des unités de traitement de flux et de la mémoire. Le nom le révèle : un profil « 1g.10gb » représente 1/7 de la puce avec 10 Go de VRAM.
Pour les fournisseurs, le slicing est un excellent moyen de remplir les baies. Pour vous, cela signifie quelque chose de simple : vous louez le nom d’un grand GPU, mais seulement une partie de sa puissance.
⚡ Pourquoi le slicing vous coûte en vitesse
Trois éléments se réduisent lorsqu’une GPU est découpée en tranches :
- Cœurs CUDA. Une tranche 2/7 d’une A100 obtient 1 792 de ses cœurs, et non 6 912.
- Bande passante mémoire. L’inference des modèles de langage (LLM) est limitée par la bande passante. Une tranche obtient une fraction correspondante du bus mémoire, ce qui fait chuter fortement les tokens par seconde.
- VRAM. Vous obtenez exactement la mémoire de la tranche. Les modèles plus grands, les contextes plus longs et les lots plus importants ne rentrent tout simplement pas.
Une carte complète et plus petite bat souvent une carte découpée et plus grande. Une carte Blackwell moderne avec tous ses cœurs est plus rapide qu’un GPU célèbre de centre de données divisé en septièmes.
📊 La comparaison : GPU classiques de centres de données vs. Trooper.AI Blibs
Nous avons comparé les offres typiques des centres de données classiques européens avec les Trooper.AI Blibs correspondants. Chaque Blib dispose de au moins la même quantité de VRAM. Pour une comparaison de prix équitable, chaque offre classique a été configurée avec exactement les mêmes cœurs CPU, RAM et stockage NVMe que le Blib auquel elle est comparée.
| GPU classique de centre de données | VRAM | Cœurs CUDA (Classique) | Trooper.AI Blib | VRAM | Cœurs CUDA (Trooper.AI) | vitesse | Prix |
|---|---|---|---|---|---|---|---|
| T4 – quart de machine | 4 GB | ~640 | Explorateur S1 · RTX A4000 | 16 GB | 6,144 | Plus rapide | jusqu’à 56 % moins cher |
| T4 – moitié de tranche | 8 GB | ~1,280 | Explorateur S1 · RTX A4000 | 16 GB | 6,144 | Plus rapide | jusqu’à 64 % moins cher |
| T4 – complet | 16 GB | 2,560 | Explorateur S1 · RTX A4000 | 16 GB | 6,144 | Plus rapide | jusqu’à 74 % moins cher |
| A10 – tranche 1/6 | 4 GB | ~1,536 | Explorateur S1 · RTX A4000 | 16 GB | 6,144 | Plus rapide | jusqu’à 61 % moins cher |
| A10 – tranche 1/3 | 8 GB | ~3,072 | Explorateur S1 · RTX A4000 | 16 GB | 6,144 | Plus rapide | jusqu’à 70 % moins cher |
| A10 – tranche 1/2 | 12 GB | ~4,608 | Explorateur S1 · RTX A4000 | 16 GB | 6,144 | Plus rapide | jusqu’à 76 % moins cher |
| A10 – complet | 24 GB | 9,216 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Plus rapide | jusqu’à 73 % moins cher |
| A100 – tranche 1/7 | 10 GB | 896 | Explorateur S1 · RTX A4000 | 16 GB | 6,144 | Plus rapide | jusqu’à 69 % moins cher |
| A100 – tranche 2/7 | 20 GB | 1,792 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Plus rapide | jusqu’à 65 % moins cher |
| A100 – tranche 3/7 | 40 GB | 2,688 | InfinityAI S1 · A100 (carte complète) | 40 GB | 6,912 | Plus rapide | jusqu’à 61 % moins cher |
| A100 – tranche complète (7/7) | 80 GB | 6,272 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Plus rapide | jusqu’à 36 % moins cher |
| L40S – complet | 48 GB | 18,176 | StellarAI L1 · RTX 4090 Pro | 48 GB | 16,384 | Plus rapide | jusqu'à 32 % moins cher |
| H200 – tranche 1/7 | 20 GB | 2,048 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Plus rapide | jusqu’à 65 % moins cher |
| H200 – tranche 2/7 | 40 GB | 4,096 | InfinityAI S1 · A100 (carte complète) | 40 GB | 6,912 | Plus rapide | jusqu’à 67 % moins cher |
| H200 – tranche 3/7 | 70 GB | 7,680 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Plus rapide | jusqu’à 36 % moins cher |
| H200 – complet | 141 GB | 16,896 | HyperionAI M2 · 2 × RTX Pro 6000 Blackwell | 192 GB | 48,128 | Vitesse égale | jusqu’à 40 % moins cher |
| RTX Pro 6000 – tranche 1/2 | 48 GB | ~12,032 | RabenAI S1 · RTX Pro 5000 Blackwell (carte complète) | 48 GB | 14,080 | Plus rapide | jusqu’à 37 % moins cher |
Une GPU en tranche n'obtient qu'une fraction de la puce : moins de CUDA cores, une bande passante mémoire proportionnellement réduite et une part de la VRAM. Un Trooper.AI Blib obtient toujours la carte complète.
🔍 Ce que le tableau vous montre
1. Une tranche n’est pas une GPU. Un « A100 avec 20 Go » en tranche 2/7 n’obtient qu’un tiers du composant. Notre Ranger S1 avec une carte complète RTX Pro 4000 Blackwell offre cinq fois plus de CUDA cores, davantage de VRAM et coûte jusqu’à 65 % moins cher.
2. Les cartes complètes l’emportent en bande passante. L’inférence des modèles de langage dépend entièrement de la bande passante mémoire. Une tranche n’en obtient qu’une fraction, tandis qu’une carte complète en utilise la totalité. C’est pourquoi une A100 ou une RTX Pro 5000 complète dépasse régulièrement une GPU « plus grande » découpée en morceaux.
3. Blackwell révolutionne les calculs. Les Tensor Cores de cinquième génération avec FP4 et FP8 natifs permettent à une seule carte RTX Pro 6000 Blackwell de surpasser une A100 entièrement allouée de 80 Go sur des modèles quantifiés modernes, avec 16 Go de VRAM supplémentaires.
4. Même l’H200 perd quand il est découpé en tranches. Une tranche 3/7 dispose de moins de la moitié des multiprocesseurs de flux et de la moitié de la bande passante mémoire, sans FP4 natif. Un RTX Pro 6000 Blackwell complet le surpasse sur les modèles quantifiés modernes, avec 26 Go de VRAM supplémentaires et jusqu’à 36 % de coût en moins. Seul l’H200 complet, non découpé, est à la hauteur de deux cartes HyperionAI, qui offrent 192 Go contre 141 Go.
5. Le L40S est un combat équitable, et nous gagnons toujours. Face à un L40S complet, notre RTX 4090 Pro 48 GB offre une bande passante mémoire plus élevée (environ 1 To/s contre 864 Go/s), ce qui compte pour l’inférence des LLM, à un coût jusqu’à 32 % inférieur.
💸 Les Coûts Cachés des « Éclats » Économiques
La tranche elle-même semble souvent abordable. La facture, non. Les centres de données classiques facturent généralement chacun séparément pour chaque vCore, chaque gigaoctet de RAM et chaque gigaoctet de stockage. Configurer une tranche avec suffisamment de RAM pour charger réellement votre modèle fait grimper le prix rapidement.
Une charge de travail IA réaliste nécessite une mémoire vive système au moins égale à sa VRAM, suffisamment de cœurs CPU pour la tokenisation et le chargement des données, ainsi qu’un stockage local rapide pour les poids des modèles. Une fois ces éléments ajoutés, une GPU en tranche est rarement l’option la moins chère.
| Facteur de coût | Partie classique de centre de données slice | Trooper.AI Blib |
|---|---|---|
| GPU | Partie d'une carte | Carte complète, bare-metal |
| cœurs CPU | Facturé par vCore | Inclus, dédié |
| RAM | Facturé par Go | Inclus, dédié |
| Stockage | Souvent en stockage réseau, facturé par Go | Stockage local NVMe jusqu’à 7,5 GB/s, inclus |
| Frais de configuration | Courant dans les offres bare-metal | Aucun |
| Facturation | Souvent mensuel ou à long terme | À l’heure, à la semaine ou au mois |
🇪🇺 Comment Trooper.AI vous donne accès à la carte GPU complète
Trooper.AI loue des serveurs GPU hébergés en UE, exploités depuis l'Allemagne, avec des GPUs complets en bare-metal dans chaque Blib. Aucun découpage, aucun silicium partagé, aucun voisin bruyant sur votre carte. Des cartes RTX A4000 jusqu'à quatre cartes RTX Pro 6000 Blackwell avec 384 Go de VRAM : vous obtenez toujours le GPU complet.
Principaux avantages :
- ✅ 100 % GPU bare-metal, CPU et RAM
- ✅ Stockage local NVMe avec jusqu’à 7,5 Go/s
- ✅ Disponibilité de 99,6 % – SLA pour clients professionnels
- ✅ Hébergé dans l’UE, accord GDPR DPA signé en un clic
- ✅ Accès complet en root et modèles IA prêts à l’emploi en un clic (vLLM, OpenWebUI, ComfyUI et bien plus)
- ✅ Facturation à l’heure, à la semaine ou au mois, avec capacité réservée Blackwell
Configurer votre machine GPU complète maintenant →
Questions fréquentes
Qu'est-ce qu'une GPU découpée ?
Un GPU découpé est une fraction d'une carte graphique physique, généralement créée avec des profils MIG ou vGPU. Vous obtenez une part fixe de la VRAM et seulement une fraction des cœurs CUDA ainsi que de la bande passante mémoire.
Une tranche d'A100 ou d'H200 est-elle plus rapide qu'une GPU moderne complète ?
Généralement non. Une tranche 1/7 ou 2/7 ne dispose que d’une petite partie de la puce originale. Une carte complète et moderne comme le RTX Pro 4000 ou le RTX Pro 6000 Blackwell offre plus de CUDA cores, une bande passante accrue et un support natif pour les formats FP4/FP8.
Quand une tranche est-elle pertinente ?
Pour des tâches d’inférence très petites et ponctuelles ou pour des bureaux virtuels où une fraction de GPU suffit, une carte complète est préférable pour l’inférence LLM, le fine-tuning ou la génération d’images.
Le slicing de GPU affecte-t-il les performances d'un modèle de langage (LLM) ?
Oui, de manière significative. L’inférence LLM est limitée par la bande passante mémoire, et une tranche n’en obtient qu’une fraction. Les tokens par seconde diminuent approximativement en proportion de la taille de la tranche.
Les GPU Trooper.AI sont-ils jamais partagés ?
Non. Chaque Blib reçoit des GPU bare-metal dédiés, des cœurs CPU et de la RAM entiers. Rien n’est partagé ou divisé entre les clients.
Quelle est la meilleure première étape ?
Vérifiez combien de VRAM votre modèle nécessite, puis choisissez le Blib full-card le plus petit qui convienne. Vous obtenez toute la puissance du GPU et pouvez effectuer une mise à niveau plus tard sans réinstaller.
Dernière mise à jour : septembre 2026. Comparaison basée sur les offres publiquement listées des fournisseurs européens classiques de centres de données (septembre 2026), configurés avec un CPU, une RAM et un stockage identiques à ceux du Trooper.AI Blib correspondant. Facturation mensuelle. Les classements de vitesse reposent sur notre évaluation fondée sur les cœurs CUDA, la bande passante mémoire, l’architecture et nos propres benchmarks TAIFlops.
QUE ATTENDEZ-VOUS ?
Louez votre propre serveur GPU dès aujourd'hui et commencez à développer des applications d'IA incroyables ! Les serveurs GPU Trooper.AI sont construits à partir de technologies haut de gamme entièrement recyclées des dernières années, conçus pour vous offrir les meilleures performances, sécurité et fiabilité pour tous vos besoins en IA.
Louer un serveur GPU pour l'IA
Localisation dans l'UE · Haute confidentialité · Excellentes performances · Meilleur support