Flowise
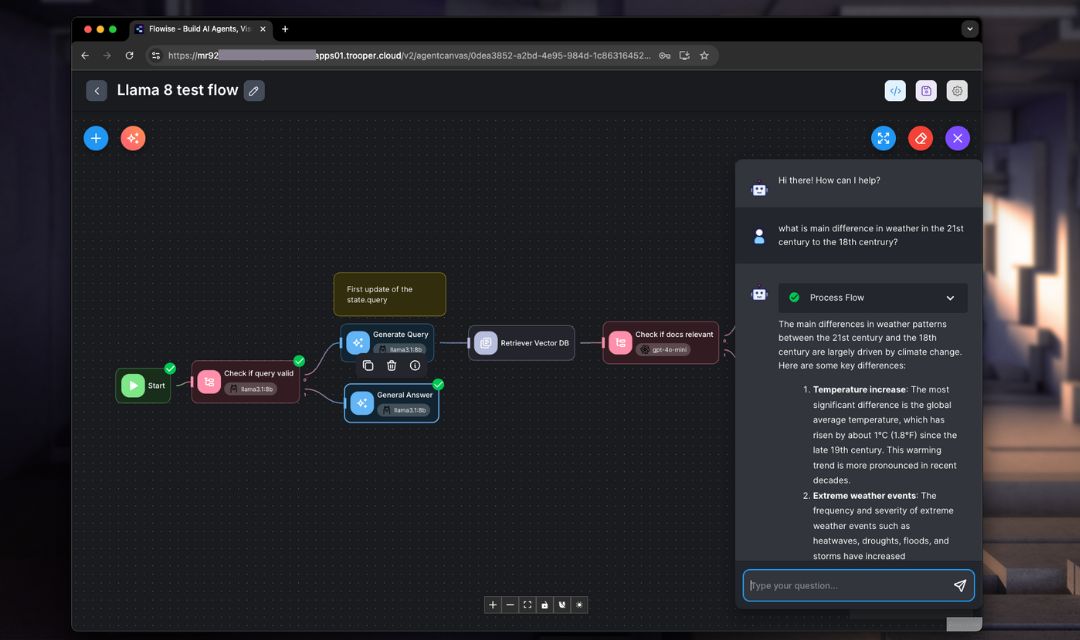
Flowise es un constructor de flujos de trabajo de IA visual y sin código que se utiliza para crear tuberías de modelos de lenguaje grande (LLM), sistemas RAG, chatbots y flujos de agentes mediante una interfaz de arrastrar y soltar.
Ofrece una interfaz basada en navegador que facilita la combinación de modelos de lenguaje grande (LLMs), bases de datos vectoriales, APIs, herramientas y lógica personalizada para crear aplicaciones completas. Flowise se centra en la prototipación rápida y el despliegue operativo en lugar de la gestión de bajo nivel de los modelos. Es de código abierto, modular y soporta entornos locales y en la nube.
Casos de uso clave
Flowise puede usarse para construir:
- Chatbots & Asistentes: Agentes conversacionales personalizados para uso interno o externo.
- Líneas de trabajo RAG: Búsqueda de documentos y respuesta a preguntas impulsadas por embeddings + bases de datos vectoriales.
- Agentes Autónomos: Flujo de trabajo impulsado por tareas activadas mediante APIs externas o lógica empresarial.
- Procesamiento de datos: Resumen, análisis de sentimiento, clasificación, extracción.
- Automatización de Negocios: Calificación de leads, enrutamiento de soporte al cliente, flujos de trabajo de contenido.
Flowise también se integra con las principales bases de datos vectoriales (Qdrant, Milvus, Chroma, Pinecone), motores locales de modelos de lenguaje (LLM) como Ollama, y proveedores en la nube de modelos de lenguaje (OpenAI, Anthropic, Mistral).
Cómo configurar Ollama local en Flowise
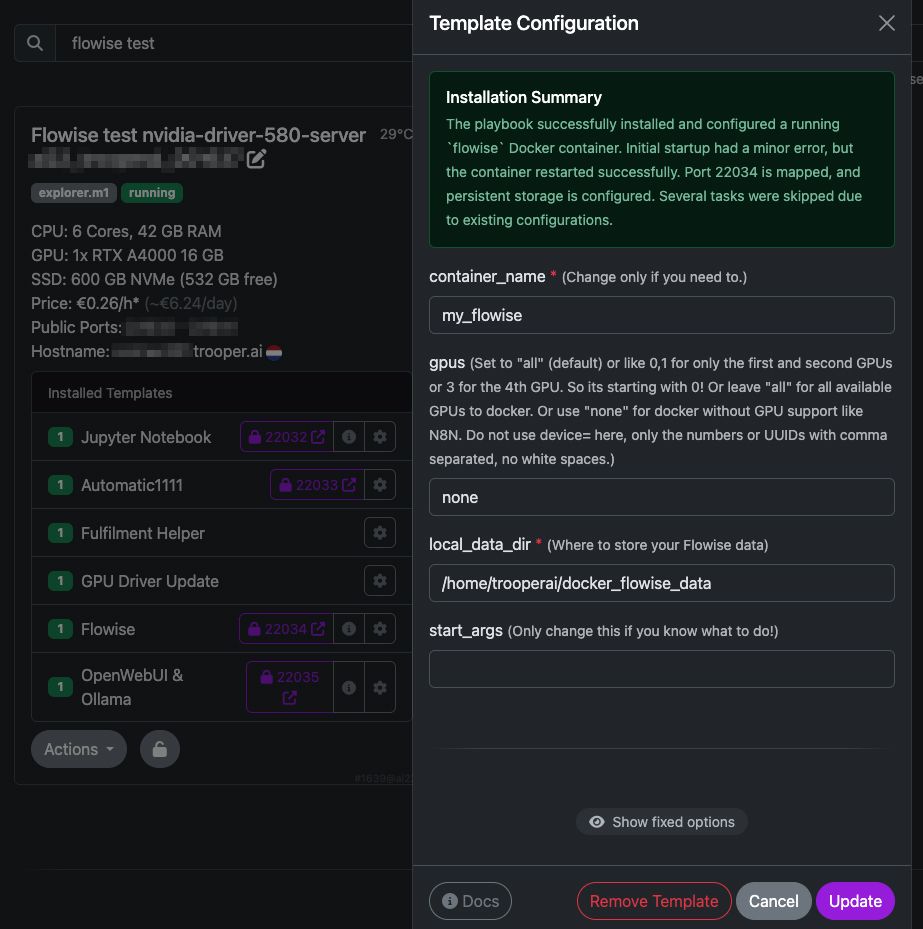
Instale el OpenWebUI & Ollama para ejecutar su servicio local de Ollama. Esta configuración está optimizada para un servidor de GPU único y se integra directamente con Flowise.
Notas de configuración
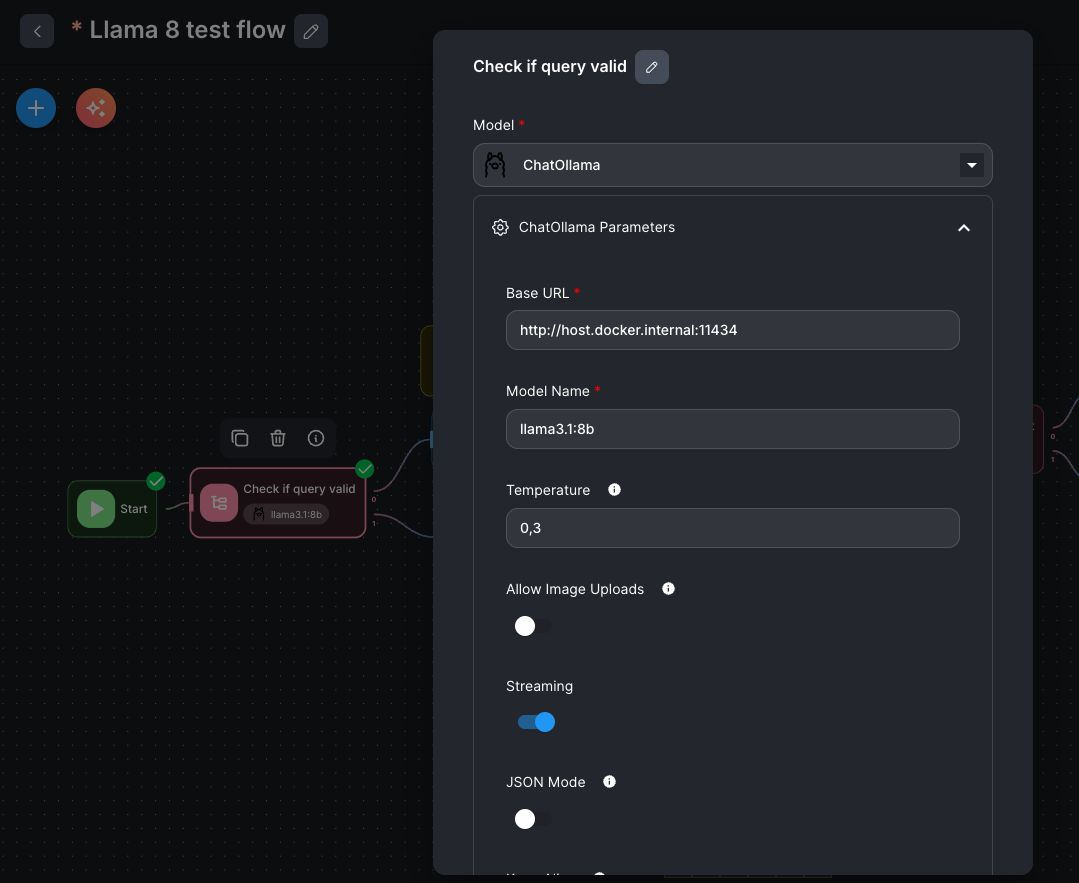
Modelo del Nodo: seleccione
ChatOllamaURL base:
Si Flowise se ejecuta en un contenedor separado →
http://host.docker.internal:11434
(Usted debe usar esto en lugar delocalhost, ya que localhost haría referencia al contenedor en sí.)Nombre del modelo:
Asegúrese de que el modelo listado en Flowise coincida exactamente con el nombre en Ollama/OpenWebUI.Temperatura:
Un valor alrededor de0.3se recomienda para tareas fácticas.
Valores más altos (por ejemplo,0.8) aumentan la creatividad, pero también el riesgo de alucinaciones.
Notas sobre el uso de la GPU
Flowise por sí mismo no requiere una GPU.
El uso de la GPU depende de los modelos detrás de Ollama u otros LLM backends.
Integración con Qdrant / Base de Datos Vectorial
Para tuberías RAG, Flowise incluye Retriever Vector DB nodos: seleccione el tipo de base de datos (ej. Qdrant), luego configure:
- URL:
http://host.docker.internal:6333 - Nombre de la colección
- Origen del modelo de incrustación
Solución de problemas típica en Flowise
1. Interfaz de usuario de Flowise no cargando en el puerto 3000
- Causa: mapeo incorrecto del puerto o configuración de red no basada en el host
- Solución: asegúrese de usar
-p 3000:3000O--network host+ abra el navegador en la IP del host correcta (asegúrese de estar utilizando nuestra plantilla predeterminada para Flowise y la URL Segura proporcionada en el Panel de Control del Servidor)
2. No se puede alcanzar Ollama / «Conexión rechazada»
- Causa:
localhostusado dentro del contenedor - Solución: use
http://host.docker.internal:11434si Flowise se ejecuta en modo puente de Docker
3. RAG no está devolviendo documentos
- Causa: embeddings faltantes o nombre incorrecto de colección en la base de datos vectorial
- Fix: verifique la salida de embeddings y corrija el nombre de la colección dentro de Qdrant/Chroma
4. Error en el flujo: «Modelo LLM no encontrado»
- Causa: cadena del modelo incorrecta
- Solución: el nombre del modelo debe coincidir exactamente con el nombre en Ollama/OpenAI/etc.
5. No se puede guardar ni cargar flujos
- Causa: volumen persistente faltante
- Solución: monte la ruta del host →
/root/.flowise
6. Modelo de GPU no utilizado
- Causa: Flowise no ejecuta modelos por sí mismo
- Solución: El GPU debe ser compatible con el motor backend (Ollama/comfyui/OpenAI local wrapper)
7. Bucle del agente / alucinación
- Causa: temperatura alta o configuración incorrecta del agente
- Solución: temperatura 0.2–0.4 + habilitar guardrails + limitar herramientas
8. Formato de salida incorrecto desde herramientas
- Causa: incompatibilidad del tipo de salida del nodo herramienta
- Solución: inserte nodos de "text parser" o "JSON parser" entre pasos
Llamar a la API de ComfyUI desde Flowise
Flowise puede llamar a la API de ComfyUI. Instale ComfyUI con nuestra plantilla: Plantilla ComfyUI para GPU Server Blibs fácilmente y de forma segura. Aún no hay un nodo nativo de Flowise, pero puede integrarse mediante el HTTP Request Node.
Ejemplo de configuración mínima:
Punto final de la API de ComfyUI
POST http://<host>:8188/prompt
Campos del nodo HTTP de Flowise:
- Método: POST
- URL:
http://host.docker.internal:8188/prompt - Encabezados:
Content-Type: application/json - Cuerpo (ejemplo):
{
  "prompt": {
    "1": {
      "inputs": {
        "seed": 1,
        "steps": 20,
        "cfg": 8,
        "sampler_name": "euler",
        "scheduler": "normal",
        "positive": "a robot with wings",
        "negative": ""
      },
      "class_type": "KSampler"
    }
  }
}
Manejo de salidas en Flowise
- agregue el nodo JSON Parse
- alimentar la respuesta al chatbot o interfaz de usuario
Consejos profesionales
Utilice nodos desencadenadores
Programar generaciones de imágenes o flujos de trabajo de modelos de lenguaje en intervalos/eventos.
Almacene las imágenes generadas
Guarde las URLs de salida de ComfyUI en Qdrant / PostgreSQL para su recuperación dentro de los flujos.
Modo asíncrono
ComfyUI hace cola con los trabajos → Flowise requiere lógica de sondeo mediante bucle + nodo HTTP Request.