Co to jest podział karty GPU?
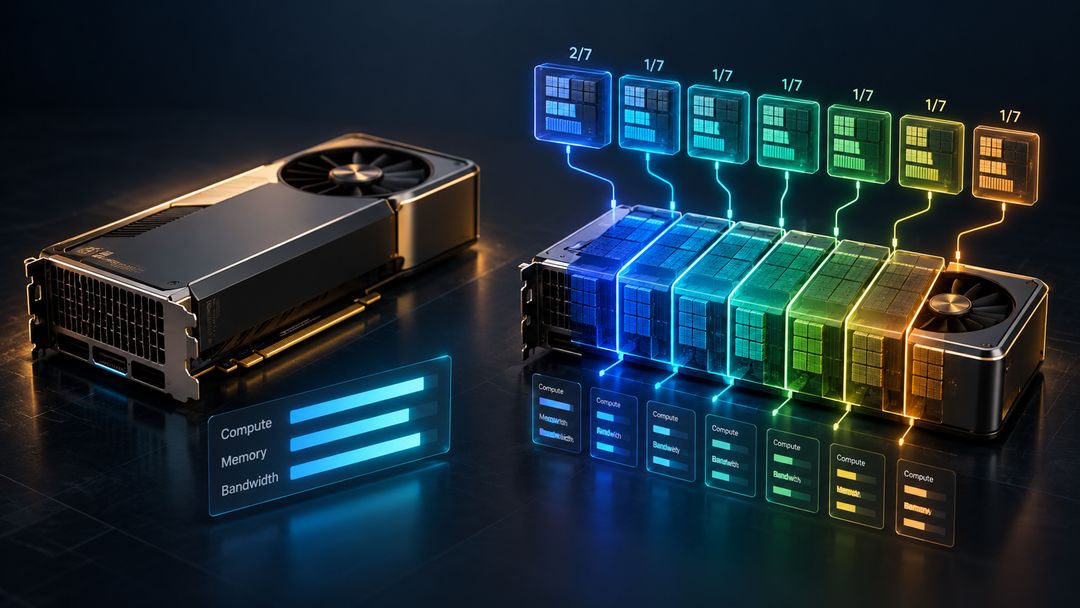
Podział karty GPU dzieli jedną fizyczną kartę graficzną na kilka mniejszych wirtualnych GPU. Każdy fragment otrzymuje ustalony udział VRAM oraz jedynie część jednostek obliczeniowych i przepustowości pamięci.
W kartach serwerowych jest to zazwyczaj realizowane za pomocą MIG (Multi-Instance GPU). Karta A100 lub H200 może zostać podzielona na maksymalnie siedem instancji, a każda otrzymuje sztywną partycję strumieniowych procesorów multiprocesorowych i pamięci. Nazwa zdradza wszystko: profil „1g.10gb” to 1/7 układu z 10 GB VRAM.
Dla dostawców podział na partie jest świetnym sposobem wypełnienia szaf serwerowych. Dla Pana/Pani to oznacza coś prostego: wynajmuje Pan/Pani nazwę potężnej karty GPU, ale tylko fragment jej mocy.
⚡ Dlaczego dzielenie na części kosztuje Pana/Pani prędkość
Trzy rzeczy zmniejszają się, gdy GPU jest podzielony:
- rdzenie CUDA. Wytnij 2/7 karty A100 dostaje 1792 jej rdzeni, a nie 6912.
- Przepustowość pamięci. Inference modeli językowych jest ograniczone przepustowością. Wycinek otrzymuje odpowiadającą frakcję magistrali pamięciowej, przez co liczba tokenów na sekundę spada gwałtownie.
- VRAM. Pan/Pani dostaje dokładnie pamięć wycinka. Większe modele, dłuższe konteksty i większe partie po prostu nie mieszczą się.
Pełna, mniejsza karta często okazuje się szybsza niż podzielona, większa. Nowoczesna karta Blackwell z pełnym zestawem rdzeni jest szybsza niż znany GPU centrum danych podzielony na siódme części.
📊 Porównanie: klasyczne GPU serwerów danych vs. Trooper.AI Blibs
Porównaliśmy typowe oferty europejskich klasycznych centrów danych z odpowiadającymi im Trooper.AI Blibami. Każdy Blib posiada co najmniej taką samą ilość VRAM. Aby porównanie cen było sprawiedliwe, każda klasyczna oferta była skonfigurowana z taką samą liczbą rdzeni CPU, RAM i pamięci NVMe jak Blib, z którym jest porównywana.
| Klasyczna GPU centrum danych | Pamięć VRAM | Rdzenie CUDA (klasyczny) | Trooper.AI Blib | Pamięć VRAM | rdzeni CUDA (Trooper.AI) | Prędkość | Cena |
|---|---|---|---|---|---|---|---|
| T4 – 1/4 części maszyny | 4 GB | ~640 | Blib Explorer S1 · RTX A4000 | 16 GB | 6,144 | Szybszy | do 56% tańsze |
| T4 – połowa maszyny | 8 GB | ~1,280 | Blib Explorer S1 · RTX A4000 | 16 GB | 6,144 | Szybszy | do {{N}}64% tańsze |
| T4 – pełna maszyna | 16 GB | 2,560 | Blib Explorer S1 · RTX A4000 | 16 GB | 6,144 | Szybszy | do {{N}}74%{{/N}} tańsze |
| A10 – 1/6 część maszyny | 4 GB | ~1,536 | Blib Explorer S1 · RTX A4000 | 16 GB | 6,144 | Szybszy | do % tańsze |
| A10 – 1/3 wycinek | 8 GB | ~3,072 | Blib Explorer S1 · RTX A4000 | 16 GB | 6,144 | Szybszy | do {{N}}70%{{/N}} tańsze |
| A10 – połowa zasobów | 12 GB | ~4,608 | Blib Explorer S1 · RTX A4000 | 16 GB | 6,144 | Szybszy | do {{N}}76%{{/N}} tańsze |
| A10 – pełna | 24 GB | 9,216 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Szybszy | do {{N}}73%{{/N}} tańsze |
| A100 – 1/7 część maszyny | 10 GB | 896 | Blib Explorer S1 · RTX A4000 | 16 GB | 6,144 | Szybszy | do {{N}}69%{{/N}} tańsze |
| A100 – 2/7 części karty | 20 GB | 1,792 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Szybszy | do {{N}}65%{{/N}} tańsze |
| A100 – 3/7 części | 40 GB | 2,688 | InfinityAI S1 · A100 (karta pełna) | 40 GB | 6,912 | Szybszy | do % tańsze |
| A100 – pełna karta | 80 GB | 6,272 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Szybszy | do {{N}}36%{{/N}} tańsze |
| L40S – pełna | 48 GB | 18,176 | StellarAI L1 · RTX 4090 Pro | 48 GB | 16,384 | Szybszy | do {{N}}32%{{/N}} tańsze |
| H200 – 1/7 część | 20 GB | 2,048 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Szybszy | do {{N}}65%{{/N}} tańsze |
| H200 – wycinek 2/7 | 40 GB | 4,096 | InfinityAI S1 · A100 (karta pełna) | 40 GB | 6,912 | Szybszy | do {{N}}67% tańsze{{/N}} |
| H200 – 3/7 części | 70 GB | 7,680 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Szybszy | do {{N}}36%{{/N}} tańsze |
| H200 – pełna | 141 GB | 16,896 | HyperionAI M2 · 2× RTX Pro 6000 Blackwell | 192 GB | 48,128 | Równa prędkość | do {{N}}40% tańsze{{/N}} |
| RTX Pro 6000 – połowa karty | 48 GB | ~12,032 | RabenAI S1 · RTX Pro 5000 Blackwell (cała karta) | 48 GB | 14,080 | Szybszy | do {{N}}37%{{/N}} tańsze |
Podzielona karta GPU otrzymuje jedynie część układu: mniej rdzeni CUDA, odpowiadającą część przepustowości pamięci oraz udział w VRAM. Trooper.AI Blib zawsze dostaje pełną kartę.
🔍 Co mówi tabela
1. Wycinek nie jest kartą GPU. „A100 z 20 GB” jako wycinek 2/7 otrzymuje mniej niż trzecią część układu. Nasz model Ranger S1 z pełną kartą RTX Pro 4000 Blackwell posiada pięć razy więcej rdzeni CUDA, więcej pamięci VRAM i kosztuje nawet o 65% mniej.
2. Pełne karty wygrywają pod względem przepustowości. Inference modeli językowych (LLM) zależy od przepustowości pamięci. Wycinek dostaje tylko jej część, natomiast pełna karta otrzymuje całość. Dlatego pełny A100 lub RTX Pro 5000 regularnie przewyższa znacznie „większą” GPU, która została podzielona na części.
3. Blackwell zmienia obliczenia. Piątegeneracyjne rdzenie Tensor Core z natywnym FP4 i FP8 pozwalają pojedynczemu RTX Pro 6000 Blackwell na wyprzedzenie nawet w pełni zaalokowanej karty 80 GB A100 w przypadku współczesnych modeli z iloczynową kwantyzacją, przy dodatkowych 16 GB VRAM.
4. Nawet H200 przegrywa, gdy jest podzielony. Podział 3/7 daje mniej niż połowę streaming multiprocessors i połowę przepustowości pamięci, oraz brak natywnego FP4. Pełna RTX Pro 6000 Blackwell wyprzedza go w nowoczesnych modelach z ilościowaniem, z dodatkowymi 26 GB VRAM i nawet o 36% niższym kosztem. Tylko pełny, niepodzielony H200 dorównuje dwóm kartom HyperionAI, które oferują 192 GB zamiast 141 GB.
5. L40S to uczciwa walka, a my wychodzimy z niej zwycięsko. Przeciwko pełnej wersji L40S nasz RTX 4090 Pro 48 GB oferuje większy przepustowość pamięci (około 1 TB/s w porównaniu do 864 GB/s), co ma kluczowe znaczenie dla wnioskowania modeli LLM, przy jednoczesnym obniżeniu kosztów o do 32%.
💸 Ukryte koszty „tanich” segmentów
Sam plik wygląda często na opłacalny. Rachunek nie. Klasyczne centra danych pobierają opłaty odrębnie za każdy vCore, każdy gigabajt pamięci RAM oraz każdy gigabajt przechowywania. Konfigurując plik z wystarczającą ilością RAM, aby rzeczywiście załadować model, cena szybko rośnie.
Realistyczne obciążenie AI wymaga pamięci RAM systemowej co najmniej równej swojej VRAM, wystarczającej liczby rdzeni CPU dla tokenizacji i ładowania danych oraz szybkiego lokalnego magazynowania dla wag modeli. Gdy Pan/Pani doda te elementy, karty graficzne w formie slice są rzadko opcją taniej.
| Czynnik kosztowy | Klasyczny wycinek centrum danych | Trooper.AI Blib |
|---|---|---|
| GPU | Część karty | Pełna karta, bare-metal |
| rdzenie CPU | Opłacane za vCore | Włączone, dedykowane |
| pamięć RAM | Opłacane za GB | Włączone, dedykowane |
| Pamięć masowa | Często sieciowo podłączone, opłacane za GB | Lokalny dysk NVMe do 7,5 GB/s, wliczony |
| Opłaty za uruchomienie | Typowe w ofertach dedykowanych (bare-metal) | Brak |
| Faktura | Zazwyczaj miesięcznie lub długoterminowo | Godzinowo, tygodniowo lub miesięcznie |
🇪🇺 Jak Trooper.AI daje Panu/Pani cały GPU
Trooper.AI wynajmuje serwery GPU hostowane w UE, działające z Niemiec, z pełnymi kartami GPU w trybie bare-metal w każdym Blibie. Bez podziału, bez współdzielonej architektury i bez hałaśliwych sąsiadów na Twojej karcie. Od modelu RTX A4000 po cztery karty RTX Pro 6000 Blackwell z 384 GB pamięci VRAM – zawsze otrzymujecie pełną kartę GPU.
Główne korzyści obejmują:
- ✅ 100% dedykowany GPU, CPU i pamięć RAM
- ✅ Lokalne magazynowanie danych na dysku NVMe z prędkością do 7,5 GB/s
- ✅ Gwarancja dostępności 99,6% SLA dla klientów biznesowych
- ✅ Hostowany w UE, umowa GDPR DPA podpisana w jeden klik
- ✅ Pełny dostęp root oraz szablony AI w jednym kliknięciu (vLLM, OpenWebUI, ComfyUI i więcej)
- ✅ Rozliczanie godzinowe, tygodniowe lub miesięczne, dodatkowo zarezerwowana pojemność Blackwell
Konfiguruj pełną maszynę z GPU już teraz →
Najczęściej zadawane pytania
Co to jest podzielony GPU?
Zestawiony GPU to część fizycznej karty graficznej, zazwyczaj tworzony za pomocą profili MIG lub vGPU. Pan/Pani otrzymuje ustalony udział w VRAM oraz tylko część rdzeni CUDA i przepustowości pamięci.
Czy podzielona karta A100 lub H200 jest szybsza niż pełna nowoczesna GPU?
Zazwyczaj nie. Wycinek 1/7 lub 2/7 posiada jedynie niewielką część oryginalnego układu. Pełna, nowoczesna karta, taka jak RTX Pro 4000 lub RTX Pro 6000 Blackwell, oferuje więcej rdzeni CUDA, większe pasmo przepustowe oraz natywne wsparcie dla FP4/FP8.
Kiedy ma sens użycie slice’a?
Dla bardzo małych, impulsowych zadań wnioskowania lub wirtualnych pulpitów, gdzie wystarcza frakcja karty GPU, lepszym wyborem jest pełna karta. Dotyczy to wnioskowania modeli językowych (LLM), precyzyjnego dostosowywania (fine-tuning) oraz generowania obrazów.
Czy dzielenie GPU wpływa na wydajność modeli językowych?
Tak, znacząco. Inference modeli językowych jest ograniczone przepustowością pamięci, a fragment karty dostaje jedynie jej część. Tokens na sekundę spadają proporcjonalnie do wielkości fragmentu.
Czy karty GPU Trooper.AI są kiedykolwiek dzielone?
Nie. Każdy Blib otrzymuje pełne, dedykowane bare-metal GPUs, rdzenie CPU oraz RAM. Nic nie jest podzielone ani udostępniane innym klientom.
Jakim powinien być pierwszy krok, Pani/Pan?
Sprawdź, ile VRAM potrzebuje Pan/Pani model, a następnie wybierz najmniejszy pełnokartowy Blib, który się do tego nadaje. Dostanie Pan/Pani całą kartę GPU i będzie mógł/a ją później ulepszyć bez ponownej instalacji.
Ostatnia aktualizacja: wrzesień 2026. Porównanie opiera się na publicznie dostępnych ofertach europejskich klasycznych dostawców centrów danych (wrześień 2026), skonfigurowanych z identycznymi CPU, RAM i magazynem jak odpowiadający im Trooper.AI Blib. Faktura miesięczna. Ocena prędkości oparta jest na rdzeniach CUDA, przepustowości pamięci, architekturze oraz naszych własnych benchmarkach TAIFlops.
NA CO JESZCZE CZEKASZ?
Wypożycz swój własny serwer GPU już dziś i zacznij tworzyć niesamowite aplikacje AI! Serwery GPU Trooper.AI są zbudowane z wyselekcjonowanego, wysokiej klasy sprzętu z ostatnich lat, zaprojektowane, aby zapewnić Ci najlepszą wydajność, bezpieczeństwo i niezawodność dla wszystkich Twoich potrzeb związanych ze sztuczną inteligencją.
Wypożycz serwer GPU do AI
Lokalizacja w UE · Wysoka prywatność · Świetna wydajność · Najlepsze wsparcie