Czy już uruchamiasz serwer z kartą graficzną i chcesz obsługiwać na nim model za pomocą vLLM, czy dopiero rozpoczynasz przygodę z prywatną inferencją LLM w hostingach EU — ta usługa Private LLM z jednym kliknięciem jest dla Ciebie.
- Rozpocznij w jeden klik: kliknij Start (godzinowo lub miesięcznie), aby uruchomić serwer GPU z preinstalowanym vLLM przy użyciu dokładnej skonfigurowanej wersji dla tego modelu.
- Tylko dostępne: Przycisk Rozpocznij jest aktywny tylko wtedy, gdy najlepsza karta graficzna jest obecnie wolna i można ją wdrożyć.
- Sprawdź jakość najpierw: otwórz Pokaż jakość odpowiedzi, aby przeczytać rzeczywiste przykłady odpowiedzi w poszczególnych kategoriach testowych przed potwierdzeniem.
| Model | Kontekst | Równoległe tok./s | Jeden tok/s | Godzinowo | Miesięcznie | Konfiguracja |
|---|---|---|---|---|---|---|
| Llama 3.3 70B 4-bit Perfect on sparbox.m2.nl-mst | 12,288 | 68 | 35 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
| Qwen3 30B 4-bit Perfect on infinityai.m1.de-nue | 84,992 | 838 | 153 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen3.6 27B 4-bit Perfect on infinityai.m1.de-nue | 58,368 | 402 | 58 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen3.6 35B 4-bit Perfect on infinityai.m1.de-nue | 52,224 | 96 | 14 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Gemma 4 31B 4-bit Perfect on sparbox.m2.nl-mst | 17,408 | 390 | 62 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
| Gemma 4 E2B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 76,800 | 914 | 133 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 117,760 +52% | 1,160 +27% | 184 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Gemma 4 E4B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 30,720 | 538 | 70 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 95,232 +205% | 737 +37% | 104 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Granite 4.1 8B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 18,432 | 339 | 46 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 76,800 +300% | 556 +64% | 76 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Llama 3.1 8B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 23,552 | 380 | 51 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 95,232 +300% | 621 +64% | 86 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Phi 4 Perfect on infinityai.m1.de-nue | 14,336 | 339 | 44 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Phi 4 multimodal Perfect on infinityai.m1.de-nue | 105,472 | 977 | 132 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Ministral 3 14B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 20,480 | 429 | 56 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 84,992 +300% | 623 +45% | 89 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Ministral 3 3B Perfect on sparbox.s1.nl-mst | 84,992 | 1,218 | 164 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| Mistral 7B Perfect on sparbox.s1.nl-mst | 28,672 | 399 | 53 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| Llama 3.1 8B 8-bit Perfect on infinityai.m1.de-nue | 117,760 | 889 | 115 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| GPT OSS 20B Perfect on infinityai.m1.de-nue | 117,760 | 685 | 201 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Ornith 1.0 9B 4-bit Perfect on ranger.s1.nl-mst | 52,224 | 78 | 59 | €0.43/h | €232.00/mo | ranger.s1.nl-mst |
| Qwen3 Coder 30B 4-bit Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 25,600 | 886 | 170 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 84,992 +224% | 949 +7% | 167 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 VL 32B 4-bit Perfect on infinityai.m1.de-nue | 28,672 | 421 | 56 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen2.5 32B 4-bit Perfect on infinityai.m1.de-nue | 28,672 | 429 | 57 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen2.5 7B Perfect on sparbox.s1.nl-mst | 28,672 | 400 | 51 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| Qwen3 14B Perfect on infinityai.m1.de-nue | 25,600 | 342 | 44 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen3 32B 8-bit Perfect on infinityai.m1.de-nue More context, higher speed on sparbox.m2.nl-mst | 7,168 | 70 | 35 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| 18,432 +162% | 297 +326% | 42 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 4B Perfect on sparbox.s1.nl-mst | 36,864 | 627 | 85 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| Qwen3 4B (2507) Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 58,368 | 626 | 84 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 117,760 +100% | 895 +43% | 121 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 8B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 23,552 | 379 | 49 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 36,864 +54% | 604 +59% | 83 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 Coder 30B 8-bit Perfect on infinityai.m1.de-nue More context on sparbox.m2.nl-mst | 25,600 | 777 | 136 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| 41,984 +62% | 812 | 153 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 VL 32B 8-bit Perfect on sparbox.m2.nl-mst | 15,360 | 294 | 41 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
| Qwen3 VL 4B Perfect on novatesla.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 69,632 | 436 | 68 | €0.34/h | €182.00/mo | novatesla.m1.nl-mst |
| 117,760 +69% | 874 +101% | 119 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3.5 9B Perfect on sparbox.s1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 20,480 | 115 | 17 | €0.35/h | €188.00/mo | sparbox.s1.nl-mst |
| 95,232 +344% | 558 +384% | 82 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3.6 27B 8-bit Perfect on infinityai.m1.de-nue | 23,552 | 291 | 41 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Gemma 4 31B 8-bit Perfect on sparbox.m2.nl-mst | 8,192 | 286 | 43 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
Kontekst = maksymalnie wykorzystywalne okno kontekstu. Równoległe/Jednokrotne = tokeny/sek. Cennik odzwierciedla najlepszy stosunek ceny do wydajności GPU na model. Cena jest zapłacona z góry; zachowujesz pełny dostęp root.
Chcesz tylko serwer z kartą graficzną?
Nie musisz tutaj wybierać modelu – zamów serwer z gołą kartą graficzną i uruchom na nim wszystko, co chcesz, mając pełny dostęp root.
Zamów serwer GPUTwoje panele vLLM gotowe od razu po wdrożeniu
Kilka sekund po kliknięciu Start Twoja prywatna wersja modelu jest dostępna za interfejsem kompatybilnym z OpenAI – śledź przepustowość, zużycie kontekstu i żądania ze swojego panelu sterowania.
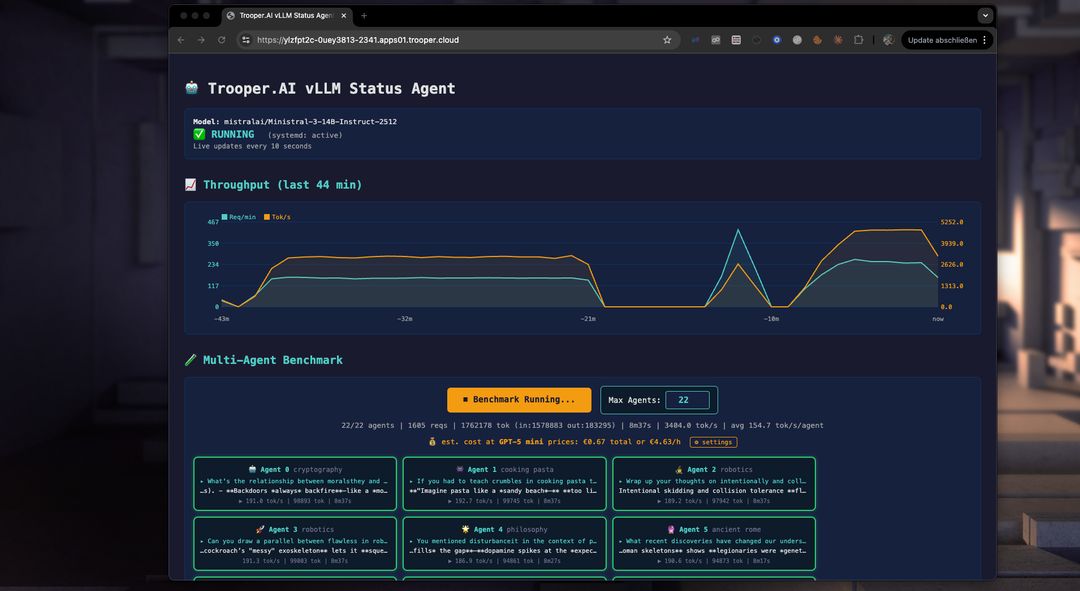
Najważniejsze 10 funkcji Twojego prywatnego serwera GPU z modelem LLM
- Rozpocznij wLLM z jednym kliknięciem — twojej model uruchamia się z dokładnie sprawdzoną konfiguracją (długość kontekstu, równoległość, flagi uruchomieniowe)
- API kompatybilne z OpenAI gotowe do użycia — skieruj swój istniejący SDK na prywatny punkt końcowy
- Całkowicie prywatna inferencja — twoje prompy i dane nigdy nie opuszczają Twojego serwera
- Klasa ochrony III (NL/FR) oraz certyfikacja ISO 27001 (DE) centra danych UE 🇪🇺, zgodne z GDPR z jednoclickowym DPA/AVV
- Pełny dostęp SSH z uprawnieniami root — dopasowuj, wymieniaj modele lub instaluj dodatkowe oprogramowanie AI obok vLLM
- Profesjonalnie przetestowane sterowniki GPU oraz najnowsze CUDA — bez konieczności ręcznego dostosowywania wersji sterowników
- w pełni dedykowane wykorzystanie karty GPU — wydajność w tokensach na sekundę, jaką widzisz w testach, jest dokładnie taka sama, jaką otrzymasz
- Darmowy SSL 🔒 na Twoim końcu (HTTPS & WSS) oraz dostosowywalny firewall poziomu sieciowego
- Trwałe przechowywanie danych z możliwością wstrzymania/wznowienia — zachowaj swój model i wagę, przestań płacić podczas nieaktywności
- 🚀 Aktualizuj sprzęt w dowolnym momencie — przejdź na większą kartę GPU dla szerszego kontekstu lub modeli bez ponownej instalacji
Zarządzany serwer GPU z wstępnie zainstalowanym vLLM
Trooper.AI daje Ci zarządzany serwer GPU z wstępnie zainstalowanym vLLM, gotowy do obsługi dowolnego otwartego dużego modelu językowego przez szybkie, kompatybilne z OpenAI API. Zamiast spędzać godziny na dobieraniu karty graficznej, instalowaniu sterowników CUDA, kompilacji vLLM i dostosowywaniu flag uruchomieniowych, wybierasz powyższy model i klikasz Start. W ciągu kilku minut otrzymujesz dedykowany serwer GPU hostowany w UE ze już działającym vLLM w dokładnej konfiguracji, którą przetestowaliśmy dla tego modelu – uwzględniono długość kontekstu, równoległość oraz argumenty wiersza poleceń.
Dlaczego serwer z wstępnie zainstalowanym vLLM?
vLLM jest standardowym silnikiem wysokoprzepustowego wnioskowania (inference), ale przygotowanie go do produkcji może być skomplikowane: dopasowywanie wersji sterowników i CUDA, wybór parametrów takich jak --max-num-batched-tokens, --max-num-seqs oraz odpowiedniego okna kontekstowego dla dostępnej pamięci VRAM Twojej karty graficznej, a także potwierdzenie prawidłowego załadowania modelu. Nasz zarządzany serwer GPU z wstępnie zainstalowanym vLLM eliminuje te trudności. Każda konfiguracja na tej stronie pochodzi bezpośrednio z automatycznych testów przeprowadzonych na rzeczywistym sprzęcie, więc rozmieścony przez Ciebie serwer zachowa się dokładnie tak samo jak przetestowana instancja – bez potrzeby eksperymentowania.
Prywatny, hostowany w UE i Twoje własne
Każdy serwer działa na dedykowanych kartach graficznych (bare-metal GPUs) w centrach danych w Niemczech certyfikowanych zgodnie z normą ISO/IEC 27001 i spełniających wymogi GDPR. Masz pełny dostęp root przez SSH, maszynę trwałą oraz prywatne endpointy – twoje zapytania i dane nigdy nie opuszczają Twojego serwera. Ponieważ jest to pełnowartościowy serwer GPU (nie dzielona inferencja), możesz również zainstalować dodatkowe oprogramowanie AI, dokonywać fine-tuningu lub uruchamiać modele obrazowe i audio obok swojego LLM.
Przejrzysty stosunek ceny do wydajności
Dla każdego modelu pokazujemy kartę graficzną z najlepszą relacją ceny do wydajności, przy uczcinych cenach godzinowych i miesięcznych. Możesz sprawdzić rzeczywiste przykłady odpowiedzi dla danego modelu za pomocą Pokaż jakość odpowiedzi, jeszcze przed wdrożeniem, aby znać zarówno prędkość oraz jakość odpowiedzi, za którą płacisz. Płaci się godzinowo podczas eksperymentów lub miesięcznie na potrzeby produkcji – serwer GPU zarządzany z wstępnie zainstalowanym vLLM, który skaluje się wraz z Twoimi wymaganiami.
Własny Prywatny Serwer GPU z Modelem Językowym
Prywatny serwer GPU z wdrożonym modelem LLM daje Ci pełną kontrolę nad maszyną: dostęp na poziomie roota, prywatne API kompatybilne z OpenAI, nieograniczoną liczbę żądań za stałą opłatą przedpłaconą oraz możliwość dopasowywania modeli, wymiany ich lub uruchamiania obciążenia obrazowego i dźwiękowego obok Twojego LLM. Ponieważ GPU jest wyłącznie Twój, przepustowość i długość kontekstu są przewidywalne, a Twoje zapytania nigdy nie opuszczają serwera – idealne dla stabilnego ruchu i rygorystycznych wymagań dotyczących poufności.
Wybierz model z powyższej macierzy i kliknij Start: w ciągu kilku minut otrzymasz serwer GPU hostowany w UE z już uruchomionym vLLM zgodnie z dokładną skonfigurowaną wersją testową — uwzględniony jest rozmiar kontekstu, równoległość oraz flagi uruchomieniowe. Płacisz godzinowo za eksperymentowanie lub miesięcznie dla produkcji, a także możesz dowolnie ulepszyć GPU na większe możliwości kontekstowe lub modele bez ponownej instalacji.
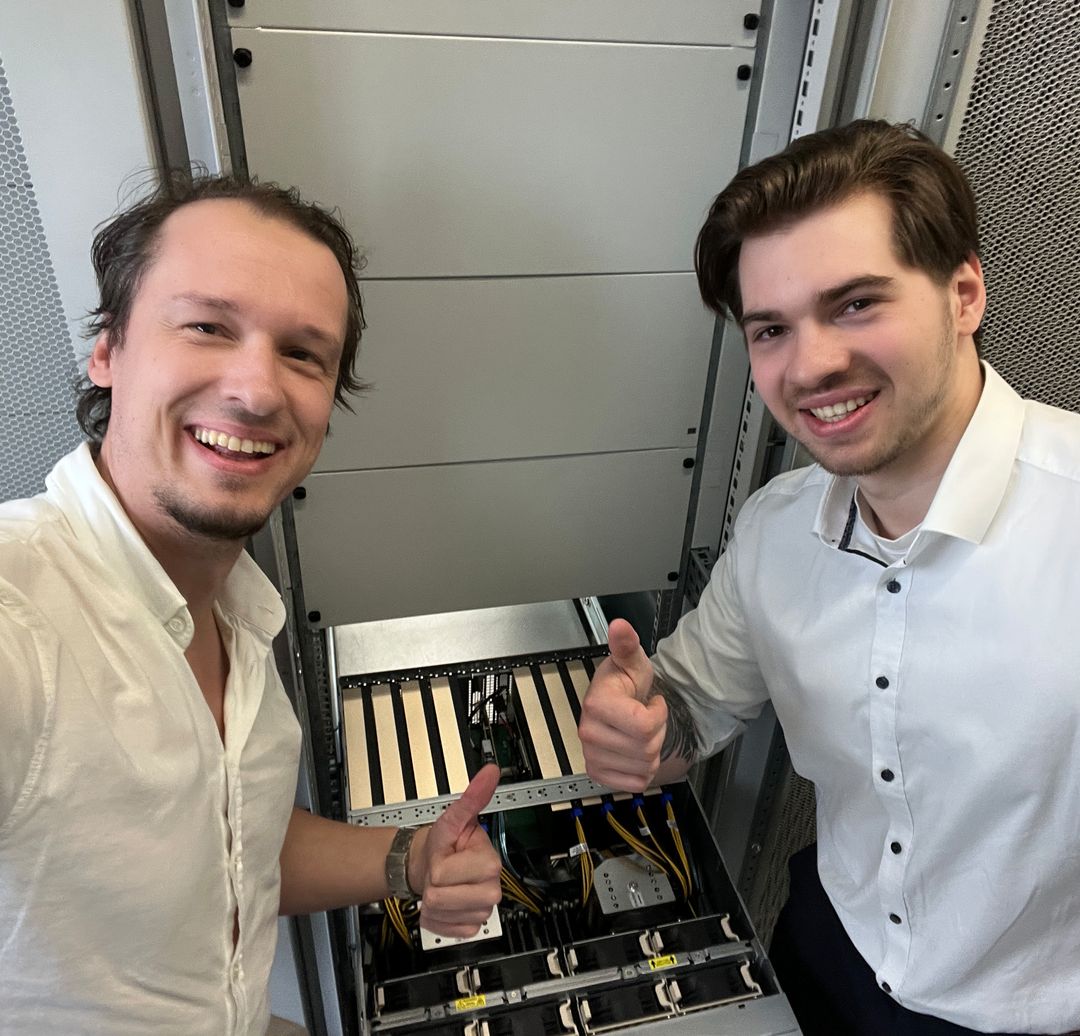
Sprawdzone Sprzęt, Budowane przez Ekspertów
Za każdym prywatnym serwerem GPU z wdrożonym vLLM stoi sprzęt klasy enterprise, poddawany procesowi recyklingu i utrzymywany przez nasz zespół. Na zdjęciu Markus i Jaimie montują klaster NVIDIA A100 w jednym z naszych certyfikowanych centrum kolokacji zgodnych ze standardem ISO/IEC 27001 w Niemczech – dokładnie taki sam typ serwerów GPU, jakie można rozmieścić za pośrednictwem tej strony. Przetwarzamy wysokowydajne komponenty na optymalizowane urządzenia do inferencji, przedłużając tym samym żywotność sprzętu przy jednoczesnej redukcji odpadów elektronicznych. Nie handlujemy pojemnością trzecich stron; posiadamy i eksploatujemy własny sprzęt w centrach danych typu colocation w Niemczech oraz Holandii, co pozwala nam zagwarantować wydajność, bezpieczeństwo oraz rezydentność danych na wszystkich poziomach infrastruktury.
Kompatybilny z API OpenAI Chat Completions — Przenieś swój stos AI w kilka minut
Twój prywatny serwer vLLM udostępnia punkt końcowy w pełni zgodny z formatem interfejsu API OpenAI Chat Completions (//v1/chat/completions). Jeśli Twoja aplikacja już używa OpenAI SDK — dla Pythona, Node.js lub dowolnego klienta HTTP — wystarczy skierować ją na własny serwer; zmiana wymaga jednej linii kodu: aktualizacji adresu bazowego i klucza API. Otrzymasz ten sam schemat żądań i odpowiedzi oraz pełne wsparcie dla strumieniowania, trybu JSON, wywoływania funkcji i wejść multimodalnych. Bez rewizji kodu, bez nowych abstrakcji, bez zamknięcia dostawcy — integracja pozostaje przenośna, a Ty zachowujesz kontrolę.
Szukasz alternatywy dla OpenAI API hostowanej w Europie? Prywatny serwer GPU z modelami językowymi zapewnia równoważną funkcjonalność API Chat Completions wraz z rezydencją danych w UE, stałą ceną przedpłaconą oraz pełnym własnością maszyny.
Działa z narzędziami, które już używasz
Ponieważ Twój serwer obsługuje interfejs OpenAI Chat Completions API, możesz go podłączyć niemal do każdego narzędzia AI, środowiska IDE lub platformy automatyzacji — wystarczy wskazać adres podstawowej strony na własnym końcu i dodać swój klucz.
… i wiele więcej — każda aplikacja, agent lub SDK obsługujące kompatybilny z OpenAI endpoint działa gotowe do użycia.