Aggiustamento di Ministral-3 su vLLM
Una Guida Pratica alle Risposte in Testo Puro e JSON
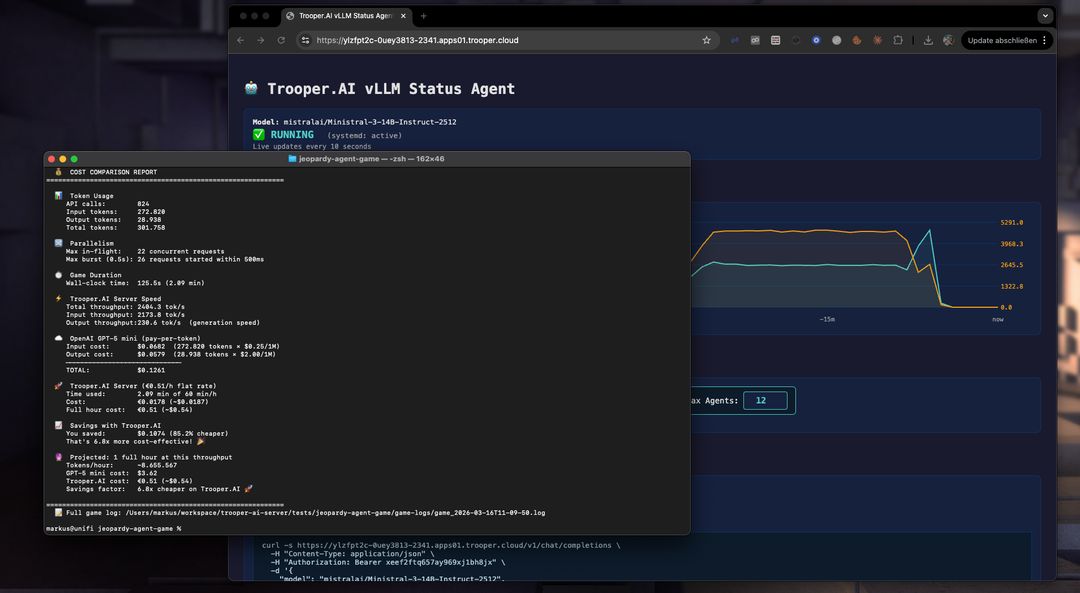
Lezioni apprese durante la costruzione di una simulazione di AI Jeopardy con 12 giocatori alimentata da Ministral-3-14B-Instruct-2512.
Una Guida Pratica alle Risposte in Testo Puro e JSON
Lezioni apprese durante la costruzione di una simulazione di AI Jeopardy con 12 giocatori alimentata da Ministral-3-14B-Instruct-2512.
Eseguire Ministral-3 su vLLM è sorprendentemente potente. Il modello è veloce, creativo e in grado di produrre risposte di alta qualità anche sotto carichi di lavoro elevati.
Ma non appena si passa da semplici prompt di chat a uscite strutturate, automazione o utilizzo programmatico, le cose diventano rapidamente complicate.
Durante lo sviluppo di un gioco di Jeopardy guidato dall'AI con 12 giocatori simultanei e centinaia di chiamate al modello, abbiamo riscontrato diversi problemi pratici:
Questa guida riassume le lezioni pratiche apprese risolvendo questi problemi, insieme a modelli concreti che Lei può riutilizzare nei propri progetti.
Il progetto di benchmark di cui parliamo simula una partita completa di Jeopardy dove:
Un singolo turno di gioco può facilmente superare 800 chiamate API.
Questo ambiente ha evidenziato casi limite che raramente compaiono nelle semplici dimostrazioni — rendendolo una eccellente piattaforma di test per comprendere come Ministral si comporta sotto carichi di lavoro produttivi reali.
I modelli Ministral non utilizzano la configurazione standard del tokenizer di HuggingFace.
Ciò significa che il comando di avvio deve abilitare esplicitamente il formato Mistral tokenizer.
vllm serve mistralai/Ministral-3-14B-Instruct-2512 \
  --tokenizer_mode mistral \
  --config_format mistral \
  --load_format mistral
Se la Sua applicazione si basa su function calling, aggiunga le bandiere degli strumenti:
--enable-auto-tool-choice
--tool-call-parser mistral
A differenza di altri modelli, Ministral non supporta chat_template_kwargs.
Se invia una richiesta come questa:
{
  "chat_template_kwargs": {
    "enable_thinking": false
  }
}
vLLM restituisce:
HTTP 400: chat_template is not supported for Mistral tokenizers
Ciò significa che funzionalità come la attivazione/disattivazione esplicita della "modalità di riflessione" (utilizzata con modelli come Qwen o DeepSeek) sono semplicemente non disponibili.
Fortunatamente, questo è raramente necessario perché Ministral produce già output concisi per impostazione predefinita.
La documentazione ufficiale di vLLM utilizza costantemente il seguente valore con Ministral-3:
temperature = 0.15
A prima vista questo valore sembra estremamente basso. Tuttavia, si rivela fondamentale per i compiti strutturati.
Con l'impostazione predefinita nello stile di OpenAI:
temperature: 0.7
il modello diventa troppo creativo nella struttura.
Una richiesta semplice come:
{ "expertise": "2-3 topics they know best" }
potrebbe restituire qualcosa come:
{
  "expertise": [
    {
      "category": "Gourmet Pizza Alchemy",
      "detail": "Can transform random ingredients into Michelin-star pizza"
    },
    {
      "category": "Sumo Wrestling Physics",
      "detail": "Understands body mechanics and center-of-gravity combat"
    }
  ]
}
Sebbene tecnicamente sia un JSON valido, non è ciò che lo schema richiedeva.
Il risultato:
max_tokens i limiti vengono superati0.15 funziona meglioA bassa temperatura il modello diventa strutturalmente disciplinato.
temperature: 0.15
Vantaggi:
Anche la generazione di testo creativo rimane forte — il modello smette semplicemente di improvvisare con la struttura.
Raccomandazione:
Utilizzi temperature: 0.15 come valore predefinito per Ministral-3.
Produrre JSON leggibile da macchina dagli LLM è più difficile di quanto sembri.
Ministral tende a interpretare i campi dello schema in modo semantico anziché strutturale, il che porta a una struttura profondamente annidata.
Un prompt come:
Return JSON with these fields.
spesso genera strutture verbose.
Esempio di richiesta:
{ "expertise": "2-3 topics they know best" }
Risposta tipica:
{
  "expertise": [
    {
      "category": "Ancient Roman Engineering",
      "detail": "Knows aqueduct systems in surprising detail"
    },
    {
      "category": "Pizza Dough Chemistry",
      "detail": "Obsessed with yeast fermentation dynamics"
    }
  ]
}
Questo consuma tre volte i token attesi.
La soluzione più affidabile combina due istruzioni.
Respond with ONLY valid JSON.
No markdown, no explanation, no text before or after the JSON.
Keep values as short plain strings — never use nested objects or arrays.
Proprio accanto alla definizione dello schema:
Every value MUST be a short plain string — NO arrays, NO nested objects.
Combinato con temperature 0.15, ciò produce JSON piatto e prevedibile.
Anche quando vincolato, Ministral tende a produrre valori più lunghi rispetto ad altri modelli.
Esempio di osservazione dal nostro benchmark:
| Modello | Tokens necessari |
|---|---|
| GPT-4o | ~512 |
| Qwen | ~512 |
| Ministral-3 | ~1024 |
Una regola sicura:
Preveda un budget di 1.5–2 volte i token per le uscite in formato JSON.
Anche con prompt perfetti, i modelli generano occasionalmente JSON malformati.
Una buona strategia è aggiungere strati di parsing difensivo.
function extractJSON(raw, shape) {
  var text = raw.replace(/^```(?:json)?\s*/i, '').replace(/\s*```$/i, '').trim();
  if (shape === 'array') {
    var m = text.match(/\[[\s\S]*\]/);
    if (m) text = m[0];
  } else {
    var m = text.match(/\{[\s\S]*\}/);
    if (m) text = m[0];
  }
  return text;
}
Seguire le parentesi aperte e chiuderle automaticamente:
var stack = [];
var inStr = false, esc = false;

for (var i = 0; i < text.length; i++) {
  var ch = text[i];

  if (esc) { esc = false; continue; }
  if (ch === '\\') { esc = true; continue; }
  if (ch === '"') { inStr = !inStr; continue; }
  if (inStr) continue;

  if (ch === '{') stack.push('}');
  else if (ch === '[') stack.push(']');
  else if (ch === '}' || ch === ']') stack.pop();
}

text = text.replace(/,\s*$/, '');

while (stack.length > 0)
  text += stack.pop();
Se il modello restituisce ancora strutture annidate:
if (Array.isArray(value)) {
  flat = value.map(function(item) {
    if (typeof item === 'string') return item;
    if (typeof item === 'object') return Object.values(item).join(' — ');
    return String(item);
  }).join(', ');
}
Un semplice ciclo di retry aumenta notevolmente la affidabilità.
Poiché Ministral si comporta in modo coerente a temperatura bassa, i tentativi di riavvio solitamente hanno successo.
Raccomandato:
2–3 retry attempts
Ministral adora la formattazione.
Anche quando Lei chiede un testo semplice, tende a produrre:
Accade perché il modello viene fornito con un prompt di sistema integrato che incoraggia la formattazione Markdown ricca.
Molte pipeline si basano su controlli di stringhe semplici.
Esempio:
verdict.toUpperCase().startsWith('CORRECT')
Ma se il modello restituisce:
**CORRECT**
il controllo fallisce.
L’approccio più sicuro è quello di normalizzare tutti gli output prima dell’elaborazione.
function stripMarkdown(text) {
  if (!text) return text;

  var s = text.replace(/\*\*([^*]+)\*\*/g, '$1');
  s = s.replace(/__([^_]+)__/g, '$1');
  s = s.replace(/\*([^*]+)\*/g, '$1');
  s = s.replace(/^#{1,6}\s+/gm, '');
  s = s.replace(/`([^`]+)`/g, '$1');
  s = s.replace(/^```[a-z]*\s*$/gm, '');

  return s.trim();
}
Applichi questo a ogni risposta del modello, non solo a Ministral.
Evita il branching specifico del model e mantiene i pipelines coerenti.
Se il Suo sistema supporta più famiglie di modelli (Mistral, Qwen, DeepSeek, Llama, ecc.), la soluzione più manutenibile è quella di centralizzare il comportamento del modello in un unico luogo.
Esempio:
function buildModelProfile(modelName) {
  var lower = modelName.toLowerCase();
  var isMistral = lower.includes('mistral') || lower.includes('ministral');

  return {
    family: isMistral ? 'Mistral' : 'Generic',

    jsonSystemInstruction: isMistral
      ? 'Respond with ONLY valid JSON. No markdown. Keep values as short plain strings.'
      : 'You output only valid JSON. No markdown fences, no explanation.',

    jsonSchemaHint: isMistral
      ? ' Every value MUST be a short plain string — NO arrays, NO nested objects.'
      : '',

    jsonTemperature: isMistral ? 0.15 : 0.7,
    defaultTemperature: isMistral ? 0.15 : 0.7,

    plainTextInstruction: ' Do not use markdown formatting.'
  };
}
Questo consente al resto del Suo sistema di rimanere model-agnostic.
Aggiungere un nuovo modello in seguito diventa banale.
| Impostazione | Valore consigliato | Motivo |
|---|---|---|
| tokenizer_mode | Mistral | Obbligatorio per il tokenizzatore corretto |
| config_format | Mistral | Obbligatorio |
| load_format | Mistral | Obbligatorio |
| chat_template_kwargs | Non inviare | Non supportato |
| temperatura | 0.15 | Evita le allucinazioni strutturali |
| istruzione JSON | Valori espliciti e piatti | Evitare oggetti annidati |
| max_tokens | 1,5–2× tipico | Il modello è prolisso |
| Pulizia Markdown | Sempre | Eviti errori di formattazione |
| riprova JSON | 2–3 tentativi | Recupero affidabile |
Ministral-3 funziona estremamente bene quando è correttamente regolato.
Una volta che Lei:
il modello diventa notevolmente prevedibile e pronto per la produzione.
Nel nostro benchmark di Jeopardy, questa configurazione ha supportato:
Tutto in esecuzione localmente su Trooper.AI infrastruttura GPU.
Provi il modello completo di distribuzione vLLM qui: vLLM Server Compatibile con OpenAI
Noleggi il Suo GPU Server oggi e inizi a creare applicazioni AI straordinarie! I Trooper.AI GPU servers sono costruiti con tecnologia high-end completamente riciclata degli ultimi anni, progettati per offrirLe le migliori prestazioni, sicurezza e affidabilità per tutte le Sue esigenze di intelligenza artificiale.
EU location · Alta privacy · Great performance · Best support