Che Lei già gestisca una macchina GPU e voglia servirvi un modello con vLLM oppure sia alle prime armi e desideri approcciare all’inferenza di modelli linguistici privati ospitati nell’UE — questo servizio Private LLM a un clic è pensato per Lei.
- Deploy con un clic: clicchi su Start (a ore o mensile) e noi avviamo una macchina GPU preinstallata con vLLM utilizzando la configurazione benchmarkata esatta per quel modello.
- Solo ciò che è disponibile: Il pulsante Start è attivo solo quando la migliore GPU è effettivamente libera per il deployment in questo momento.
- Valuti prima la qualità: apra Mostra qualità della risposta per leggere esempi reali di risposte per ogni categoria di test prima di procedere.
| Modello | ... ...il modello: è protetto da autenticazione o scaricato da un repository privato. Per i modelli pubblici questo campo può essere lasciato vuoto. È possibile generare un token qui: Code https://huggingface.co/settings/tokens Il token viene utilizzato solo durante il download del modello.maxtokensDefinisce la finestra di contesto massima che il server deve supportare. Questo influisce direttamente sull'utilizzo della VRAM. Valori tipici: Contesto Raccomandato modelli piccoli 4096 modelli medi 8192 modelli con contesto lungo 16384+ Valori più alti aumentano significativamente l'utilizzo della memoria. Se il Suo server esaurisce la VRAM, abbassi questo valore.modelnameL'identificatore del modello HuggingFace che vLLM deve caricare.Esempio: Code mistralai/Ministral-3-14B-Instruct Altri esempi compatibili: Code Qwen/Qwen2.5-14B-Instruct google/gemma Context repository Per i modelli pubblici questo campo può essere lasciato vuoto. È possibile generare un token qui: Code https://huggingface.co/settings/tokens Il token viene utilizzato solo durante il download del modello.maxtokensDefinisce la finestra di contesto massima che il server deve supportare. Questo influisce direttamente sull'utilizzo della VRAM. Valori tipici: Contesto Raccomandato modelli piccoli 4096 modelli medi 8192 modelli con contesto lungo 16384+ Valori più alti aumentano significativamente l'utilizzo della memoria. Se il Suo server esaurisce la VRAM, abbassi questo valore.modelnameL'identificatore del modello HuggingFace che vLLM deve caricare.Esempio: Code mistralai/Ministral-3-14B-Instruct Altri esempi compatibili: Code Qwen/Qwen2.5-14B-Instruct google/gemma-3-12b-it meta-llama/Meta-Llama-3-8B-Instruct ... e molti altri Assicurarsi che... | Token paralleli al secondo | Singolo t/s | Oraria | Mensile | Configurazione |
|---|---|---|---|---|---|---|
| Llama 3.3 70B 4-bit Perfect on sparbox.m2.nl-mst | 12,288 | 68 | 35 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
| Qwen3 30B 4-bit Perfect on infinityai.m1.de-nue | 84,992 | 838 | 153 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen3.6 27B 4-bit Perfect on infinityai.m1.de-nue | 58,368 | 402 | 58 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen3.6 35B 4-bit Perfect on infinityai.m1.de-nue | 52,224 | 96 | 14 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Gemma 4 31B 4-bit Perfect on sparbox.m2.nl-mst | 17,408 | 390 | 62 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
| Gemma 4 E2B Perfect on sparbox.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 76,800 | 914 | 133 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| 117,760 +52% | 1,160 +27% | 184 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Gemma 4 E4B Perfect on sparbox.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 30,720 | 538 | 70 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| 95,232 +205% | 737 +37% | 104 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Granite 4.1 8B Perfect on sparbox.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 18,432 | 339 | 46 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| 76,800 +300% | 556 +64% | 76 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Llama 3.1 8B Perfect on sparbox.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 23,552 | 380 | 51 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| 95,232 +300% | 621 +64% | 86 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Phi 4 Perfect on infinityai.m1.de-nue | 14,336 | 339 | 44 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Phi 4 multimodal Perfect on infinityai.m1.de-nue | 105,472 | 977 | 132 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Ministral 3 14B Perfect on sparbox.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 20,480 | 429 | 56 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| 84,992 +300% | 623 +45% | 89 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Ministral 3 3B Perfect on sparbox.m1.nl-mst | 84,992 | 1,218 | 164 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| Mistral 7B Perfect on sparbox.m1.nl-mst | 28,672 | 399 | 53 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| Llama 3.1 8B 8-bit Perfect on infinityai.m1.de-nue | 117,760 | 889 | 115 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| GPT OSS 20B Perfect on infinityai.m1.de-nue | 117,760 | 685 | 201 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Ornith 1.0 9B 4-bit Perfect on ranger.s1.nl-mst | 52,224 | 78 | 59 | €0.43/h | €232.00/mo | ranger.s1.nl-mst |
| Qwen3 Coder 30B 4-bit Perfect on sparbox.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 25,600 | 886 | 170 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| 84,992 +224% | 949 +7% | 167 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 VL 32B 4-bit Perfect on infinityai.m1.de-nue | 28,672 | 421 | 56 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen2.5 32B 4-bit Perfect on infinityai.m1.de-nue | 28,672 | 429 | 57 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen2.5 7B Perfect on sparbox.m1.nl-mst | 28,672 | 400 | 51 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| Qwen3 14B Perfect on infinityai.m1.de-nue | 25,600 | 342 | 44 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen3 32B 8-bit Perfect on infinityai.m1.de-nue More context, higher speed on sparbox.m2.nl-mst | 7,168 | 70 | 35 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| 18,432 +162% | 297 +326% | 42 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 4B Perfect on sparbox.m1.nl-mst | 36,864 | 627 | 85 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| Qwen3 4B (2507) Perfect on sparbox.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 58,368 | 626 | 84 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| 117,760 +100% | 895 +43% | 121 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 8B Perfect on sparbox.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 23,552 | 379 | 49 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| 36,864 +54% | 604 +59% | 83 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 Coder 30B 8-bit Perfect on infinityai.m1.de-nue More context on sparbox.m2.nl-mst | 25,600 | 777 | 136 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| 41,984 +62% | 812 | 153 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3 VL 32B 8-bit Perfect on sparbox.m2.nl-mst | 15,360 | 294 | 41 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
| Qwen3 VL 4B Perfect on infinityai.m1.de-nue | 84,992 | 893 | 117 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Qwen3.5 9B Perfect on sparbox.m1.nl-mst More context, higher speed on sparbox.m2.nl-mst | 20,480 | 115 | 17 | €0.40/h | €216.00/mo | sparbox.m1.nl-mst |
| 95,232 +344% | 558 +384% | 82 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst | |
| Qwen3.6 27B 8-bit Perfect on infinityai.m1.de-nue | 23,552 | 291 | 41 | €0.84/h | €452.00/mo | infinityai.m1.de-nue |
| Gemma 4 31B 8-bit Perfect on sparbox.m2.nl-mst | 8,192 | 286 | 43 | €0.73/h | €394.00/mo | sparbox.m2.nl-mst |
Contesto = finestra di contesto massima utilizzabile. Parallel/Single = token/sec. La tariffazione riflette il miglior rapporto qualità-prezzo GPU per modello. I prezzi sono prepagati; Lei mantiene l’accesso completo root.
Desidera solo il server con GPU?
Non deve scegliere un modello qui — ordini un server GPU nudo e esegua ciò che desidera su di esso, con accesso completo root.
Ordini un GPU ServerIl Suo dashboard vLLM, pronto subito dopo il deployment
Pochi secondi dopo aver premuto Start, il Suo modello privato è operativo dietro un endpoint compatibile con OpenAI — monitori throughput, utilizzo del contesto e richieste direttamente dal Suo dashboard.
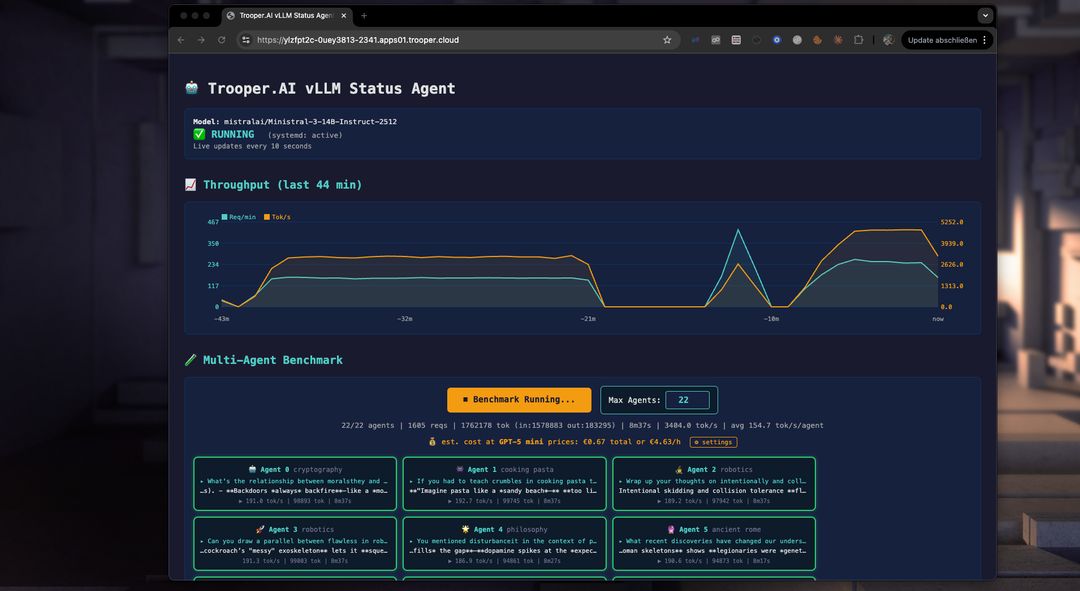
Le 10 principali funzionalità del Suo server privato LLM GPU
- Deploy vLLM in un clic — il Suo modello avvia con la configurazione esattamente benchmarkata (lunghezza contesto, parallelismo, flag di avvio)
- API compatibile con OpenAI pronto all'uso — indirizzi il Suo SDK esistente al Suo endpoint privato
- Inferenza completamente privata — i suoi prompt e dati non lasciano mai il suo server
- Tier-III (NL/FR) & ISO 27001 (DE) data center UE 🇪🇺, conforme al GDPR con DPA/AVV a un clic
- Accesso SSH completo con root — personalizzare il modello, sostituire modelli o installare software AI aggiuntivo insieme a vLLM
- Testato professionalmente GPU drivers & latest CUDA — nessuna complicazione con driver o versioni
- 100% prestazioni bare-metal GPU — i tokens/sec che Lei vede nei benchmark sono quelli che ottiene
- SSL gratuito 🔒 sul Suo endpoint (HTTPS & WSS) più un firewall di livello rete personalizzabile
- Archiviazione persistente con pausa/congelamento — conservi il Suo modello e i pesi, smetta di pagare quando inattiva
- 🚀 Aggiornamento hardware in qualsiasi momento — passare a una GPU più potente per gestire contesti o modelli più grandi senza reinstallare
Macchina GPU gestita preinstallata con vLLM
Trooper.AI Le fornisce una macchina GPU preinstallata con vLLM, pronta per servire qualsiasi modello linguistico aperto tramite una veloce API compatibile con OpenAI. Invece di impiegare ore nella selezione di una GPU, nell'installazione dei driver CUDA, nella compilazione di vLLM e nell'ottimizzazione delle opzioni di avvio, Lei seleziona un modello sopra e fa clic su Start. In pochi minuti riceve una macchina GPU dedicata ospitata in UE con vLLM già in esecuzione nella configurazione esatta che abbiamo benchmarkato per quel modello — lunghezza del contesto, parallelismo e argomenti della riga di comando inclusi.
Perché un server con vLLM preinstallato?
vLLM è il motore di inferenza ad alta throughput standard del settore, ma renderlo pronto per la produzione richiede attenzione ai dettagli: abbinare le versioni dei driver e di CUDA, scegliere --max-num-batched-tokens, --max-num-seqs e la finestra di contesto corretta per la VRAM della Sua GPU, oltre a verificare che il modello si carichi effettivamente. Il Nostro server GPU gestito preinstallato con vLLM elimina tutto questo lavoro. Ogni configurazione presente in questa pagina proviene direttamente da benchmark automatizzati su hardware reale, quindi la macchina che Lei deploia si comporterà esattamente come la prova testata — senza tentativi ed errori.
Privato, ospitato nell’UE e di Sua proprietà
Ogni server gira su GPU bare-metal ospitati in data center tedeschi certificati ISO/IEC 27001 e conformi al GDPR. Lei ottiene accesso completo in root SSH, una macchina persistente e un endpoint privato — i suoi prompt e dati non lasciano mai il Suo server. Poiché si tratta di un GPU Server completo (non inferenza condivisa), può anche installare software AI aggiuntivo, eseguire il fine-tuning o avviare modelli di immagine e audio affianco al Suo LLM.
Prezzo e prestazioni trasparenti
Per ogni modello mostriamo la GPU con il miglior rapporto qualità-prezzo, con tariffazione onesta su base oraria e mensile. Potrà visionare risposte di esempio reali per modello tramite Show response quality prima del deployment, così da conoscere sia la velocità e la qualità delle risposte per cui state pagando. Paghi su base oraria per sperimentare o mensile per la produzione — una managed GPU server preinstallata con vLLM che si adatta alle sue esigenze.
Il Suo Server Privato LLM GPU
Un server privato LLM GPU Le dà accesso completo alla macchina: accesso root totale, un endpoint compatibile con OpenAI privato, richieste illimitate a tariffa prepagata fissa e la libertà di effettuare fine-tuning, sostituire modelli o eseguire workload di immagini e audio insieme al Suo LLM. Poiché la GPU è Sua, la throughput e la lunghezza del contesto sono prevedibili e i Suoi prompt non lasciano mai il Suo server — ideale per traffico costante ed esigenze di privacy rigorose.
Selezioni un modello dalla matrice sopra e clicchi Start: in pochi minuti ottiene una macchina GPU ospitata nell’UE con vLLM già avviato nella configurazione esattamente testata — lunghezza del contesto, parallelismo e flag di lancio inclusi. Paghi su base oraria per sperimentare o mensile per la produzione, e aggiorni a una GPU più potente in qualsiasi momento per gestire contesti o modelli più grandi senza reinstallare.
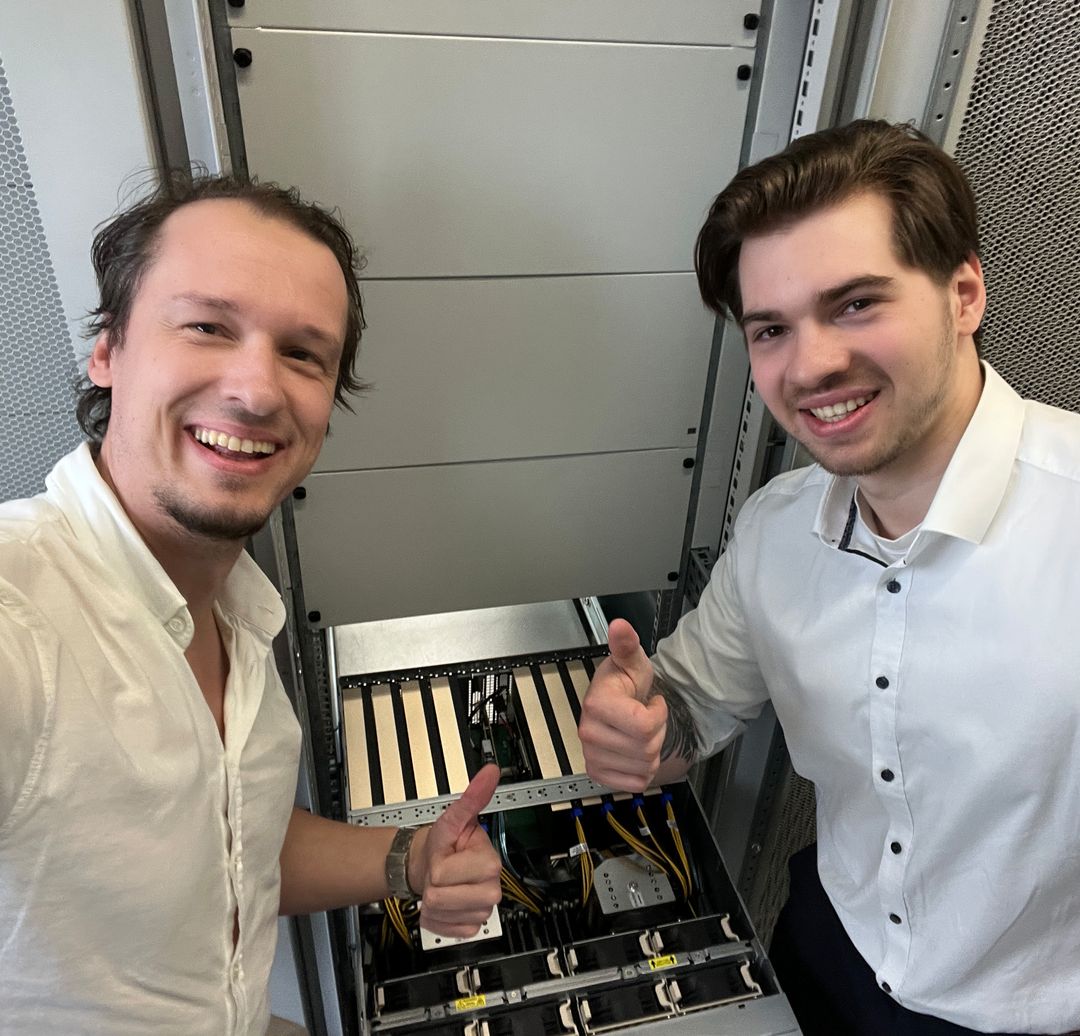
Hardware affidabile, costruito da esperti
Dietro ogni server privato LLM con GPU si trova hardware di grado enterprise, riciclato e mantenuto dal nostro team. Qui, Markus e Jaimie stanno installando un cluster NVIDIA A100 in uno dei nostri data center di collocazione certificati ISO/IEC 27001 in Germania — la stessa classe di server GPU che Lei deploja da questa pagina. Ricicliamo componenti ad alte prestazioni per crearne rig ottimizzati per l'inferenza, prolungandone il ciclo di vita e riducendo i rifiuti elettronici. Non rivendiamo capacità di terze parti; possediamo e gestiamo direttamente il nostro hardware nei data center di collocazione in Germania e nei Paesi Bassi, garantendo così prestazioni, sicurezza e residenza dei dati a ogni livello dello stack.
Compatibile con l’API OpenAI Chat Completions — Migri il Suo Stack AI in Pochi Minuti
Il Suo server privato vLLM espone un endpoint che è al 100% compatibile con il formato OpenAI Chat Completions API (/v1/chat/completions). Se la Sua applicazione utilizza già l’OpenAI SDK — Python, Node.js o qualsiasi client HTTP — puntarlo al Suo server richiede una modifica di una sola riga: aggiornare l’URL di base e la chiave API. Otterrà lo stesso schema di richiesta e risposta, con pieno supporto per lo streaming, la modalità JSON, le chiamate di funzione e gli input multimodali. Nessuna riscrittura del codice, nessuna nuova astrazione, nessun vincolo al fornitore — la Sua integrazione rimane portabile e Lei mantiene il controllo.
Cerca un'alternativa all’OpenAI API ospitata in Europa? Un server privato LLM con GPU Le offre funzionalità equivalenti all’API Chat Completions, con residenza dei dati nell’EU, un prezzo fisso prepagato e il pieno controllo sulla macchina.
Funziona con gli Strumenti che Lei Utilizza Già
Poiché il Suo server parla l’OpenAI Chat Completions API, può integrarlo in qualsiasi strumento AI, IDE o piattaforma di automazione — basta indicare l’URL di base al proprio endpoint e aggiungere la Sua chiave. Alcuni esempi popolari:
… e molti altri — qualsiasi applicazione, agente o SDK che supporta un endpoint compatibile con OpenAI funziona subito senza configurazioni aggiuntive.