Che cos'è il GPU Slicing?
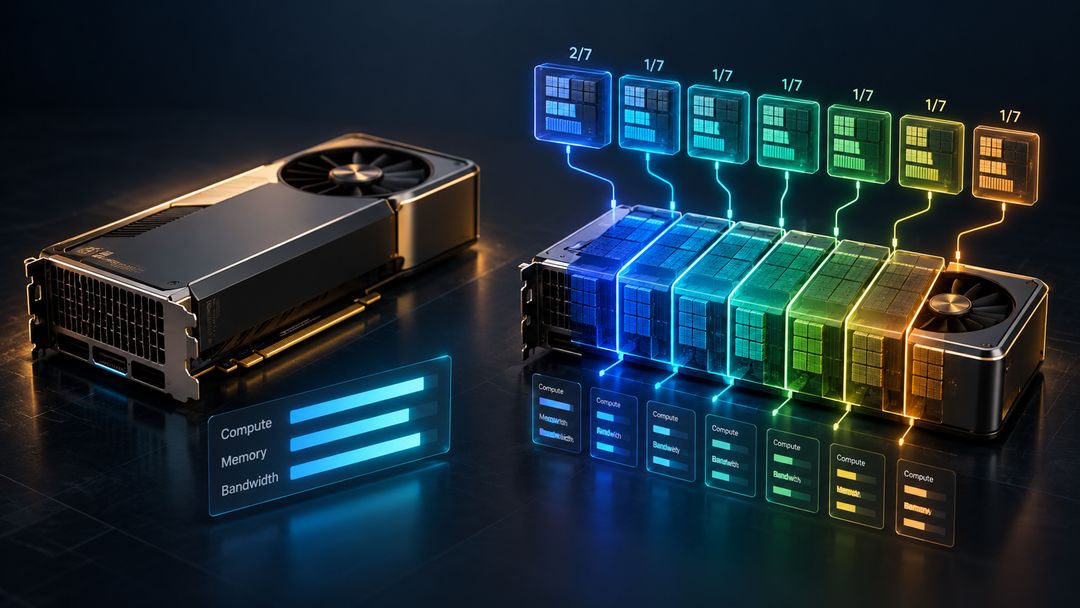
GPU slicing suddivide una scheda grafica fisica in diverse GPU virtuali più piccole. Ogni fetta riceve una quota fissa di VRAM e solo una frazione delle unità di calcolo della scheda e della banda memoria.
Nei modelli di data center questa operazione viene solitamente eseguita con MIG (Multi-Instance GPU). Un'A100 o un'H200 può essere suddivisa fino a sette istanze, e ognuna riceve una partizione fissa di unità di elaborazione in streaming e memoria. Il nome lo rivela: un profilo «1g.10gb» rappresenta 1/7 del chip con 10 GB di VRAM.
Per i fornitori, il slicing è un ottimo modo per riempire i rack. Per Lei significa una cosa semplice: Lei prende il nome di una grande GPU, ma solo una parte della sua potenza.
⚡ Perché il Slicing Le Costa Velocità
Tre elementi si riducono quando una GPU viene suddivisa:
- core CUDA. Una fetta 2/7 di un'A100 ottiene 1.792 dei suoi core, non 6.912.
- Larghezza di banda della memoria. L’inferenza dei modelli linguistici (LLM) è limitata dalla larghezza di banda. Una fetta riceve una frazione corrispondente del bus di memoria, quindi i token al secondo calano bruscamente.
- VRAM. Lei ottiene esattamente la memoria della fetta. Modelli più grandi, contesti più lunghi e batch più ampi semplicemente non ci entrano.
Una scheda più piccola e completa supera spesso una scheda più grande ma suddivisa. Una moderna GPU Blackwell con tutti i suoi core è più veloce di una famosa GPU per data center tagliata in settimi.
📊 Il confronto: GPU di Data Center Classici vs. Trooper.AI Blibs
Abbiamo confrontato le offerte tipiche dei classici data center europei con i corrispondenti Trooper.AI Blibs. Ogni Blib ha almeno la stessa VRAM. Per una comparazione equa dei prezzi, ogni offerta classica è stata configurata con esattamente gli stessi core CPU, RAM e storage NVMe del Blib con cui viene confrontata.
| GPU Classico Data Center | VRAM | Core CUDA (Classico) | Trooper.AI Blib | VRAM | Core CUDA (Trooper.AI) | Velocità | Prezzo |
|---|---|---|---|---|---|---|---|
| T4 – 1/4 fetta | 4 GB | ~640 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Più veloce | fino al 56% più economico |
| T4 – fetta 1/2 | 8 GB | ~1,280 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Più veloce | fino al 64% più economico |
| T4 – intero | 16 GB | 2,560 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Più veloce | fino al 74% più economico |
| A10 – fetta 1/6 | 4 GB | ~1,536 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Più veloce | fino al 61% più economico |
| A10 – fetta 1/3 | 8 GB | ~3,072 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Più veloce | fino al 70% più economico |
| A10 – fetta 1/2 | 12 GB | ~4,608 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Più veloce | fino al 76% più economico |
| A10 – intera | 24 GB | 9,216 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Più veloce | fino al 73% più economico |
| A100 – fetta 1/7 | 10 GB | 896 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Più veloce | fino al 69% più economico |
| A100 – fetta 2/7 | 20 GB | 1,792 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Più veloce | fino al 65% più economico |
| A100 – fetta 3/7 | 40 GB | 2,688 | InfinityAI S1 · A100 (scheda completa) | 40 GB | 6,912 | Più veloce | fino al 61% più economico |
| A100 – scheda intera | 80 GB | 6,272 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Più veloce | fino al 36% più economico |
| L40S – intera | 48 GB | 18,176 | StellarAI L1 · RTX 4090 Pro | 48 GB | 16,384 | Più veloce | fino al 32% più economico |
| H200 – fetta 1/7 | 20 GB | 2,048 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Più veloce | fino al 65% più economico |
| H200 – fetta 2/7 | 40 GB | 4,096 | InfinityAI S1 · A100 (scheda completa) | 40 GB | 6,912 | Più veloce | fino al 67% più economico |
| H200 – fetta 3/7 | 70 GB | 7,680 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Più veloce | fino al 36% più economico |
| H200 – intera | 141 GB | 16,896 | HyperionAI M2 · 2× RTX Pro 6000 Blackwell | 192 GB | 48,128 | Velocità equivalente | fino al 40% più economico |
| RTX Pro 6000 – metà scheda | 48 GB | ~12,032 | RabenAI S1 · RTX Pro 5000 Blackwell (scheda intera) | 48 GB | 14,080 | Più veloce | fino al 37% più economico |
Una GPU in slice riceve solo una frazione del chip: meno CUDA cores, una frazione corrispondente di banda memoria e una quota della VRAM. Un Trooper.AI Blib ottiene sempre la scheda completa.
🔍 Cosa Le Dice la Tabella
1. Una fetta non è una GPU. Un «A100 da 20 GB» come fetta 2/7 ottiene meno di un terzo del chip. Il nostro Ranger S1 con scheda completa RTX Pro 4000 Blackwell offre cinque volte più CUDA cores, maggiore VRAM e costa fino al 65% in meno.
2. Le schede complete vincono in termini di banda passante. L’inferenza dei modelli linguistici dipende interamente dalla banda passante della memoria. Una fetta ne ottiene solo una frazione, mentre una scheda completa ne utilizza tutta. Per questo motivo, una A100 o una RTX Pro 5000 intera supera regolarmente una GPU molto più “grande” ma suddivisa in parti.
3. Blackwell cambia le regole del gioco. I Tensor Cores di quinta generazione con supporto nativo per FP4 e FP8 consentono a una singola scheda RTX Pro 6000 Blackwell di superare persino una A100 da 80 GB completamente allocata nei modelli quantizzati moderni, con 16 GB in più di VRAM.
4. Anche l’H200 perde quando viene suddiviso. Una fetta da 3/7 ha meno della metà dei streaming multiprocessors e metà della banda memoria, oltre a non avere FP4 nativo. Un RTX Pro 6000 Blackwell completo lo supera nei modelli quantizzati moderni, con 26 GB di VRAM in più e fino al 36% di costo inferiore. Solo l’H200 intero, non suddiviso, è alla pari con due schede HyperionAI, che offrono 192 GB invece di 141 GB.
5. Il confronto con l’L40S è equo, e noi vinciamo comunque. Contro un L40S completo, la nostra scheda RTX 4090 Pro da 48 GB offre una maggiore larghezza di banda della memoria (circa 1 TB/s contro 864 GB/s), che è ciò che conta per l’inferenza dei modelli LLM, a un costo fino al 32% inferiore.
💸 I Costi Nascosti delle «Slice» a Prezzo «Basso»
La fetta stessa spesso sembra conveniente. Il conto non lo è. I data center classici solitamente addebitano separatamente per ogni vCore, ogni gigabyte di RAM e ogni gigabyte di storage. Configuri una fetta con sufficiente RAM per caricare effettivamente il Suo modello e il prezzo sale velocemente.
Un carico di lavoro AI realistico richiede RAM di sistema almeno pari alla sua VRAM, un numero sufficiente di core CPU per la tokenizzazione e il caricamento dei dati, nonché un veloce archiviazione locale per i pesi del modello. Una volta aggiunti questi requisiti, una GPU suddivisa è raramente l’opzione più economica.
| Fattore di costo | Slice classico di data center | Trooper.AI Blib |
|---|---|---|
| GPU | Frazione di una scheda | Scheda completa, bare-metal |
| core CPU | Addebitato per vCore | Inclusi, dedicati |
| RAM | Addebitato per GB | Inclusi, dedicati |
| Archiviazione | Di solito collegato in rete, fatturato a GB | NVMe locale fino a 7,5 GB/s, incluso |
| Costi di configurazione | Comune nelle offerte bare-metal | Nessuno |
| Fatturazione | Di solito mensili o contratti a lungo termine | Ore, settimanale o mensile |
🇪🇺 Come Trooper.AI Le Fornisce l’intera GPU
Trooper.AI affitta macchine GPU ospitate in UE, gestite dalla Germania, con GPU bare-metal complete in ogni Blib. Nessun slicing, nessun silicio condiviso, nessun vicino rumoroso sulla Sua scheda. Dall’RTX A4000 fino a quattro schede RTX Pro 6000 Blackwell con 384 GB di VRAM, Lei ottiene sempre la GPU completa.
I principali vantaggi includono:
- ✅ 100% GPU, CPU e RAM in bare-metal
- ✅ Archiviazione locale NVMe con fino a 7,5 GB/s
- ✅ SLA di disponibilità del 99,6% per clienti aziendali
- ✅ ospitato nell’UE, GDPR DPA firmato in un clic
- ✅ Accesso completo root e modelli AI preconfigurati in un clic (vLLM, OpenWebUI, ComfyUI e altro)
- ✅ Fatturazione oraria, settimanale o mensile, più capacità riservata Blackwell
Configuri la Sua macchina GPU completa ora →
Domande frequenti
Che cos'è una GPU suddivisa?
Un GPU suddiviso è una frazione di una scheda grafica fisica, solitamente creata con profili MIG o vGPU. Lei ottiene una quota fissa della VRAM e solo una frazione dei core CUDA e della larghezza di banda della memoria.
Una GPU A100 o H200 suddivisa è più veloce di una GPU moderna completa?
Di solito no. Una fetta da 1/7 o 2/7 contiene solo una piccola parte del chip originale. Una scheda moderna completa come l’RTX Pro 4000 o l’RTX Pro 6000 Blackwell offre più core CUDA, maggiore banda passante e supporto nativo per FP4/FP8.
Quando ha senso utilizzare una fetta di GPU?
Per compiti di inferenza molto piccoli e impulsivi o desktop virtuali dove una frazione di GPU è sufficiente. Per l’inferenza di LLM, il fine-tuning o la generazione di immagini, una scheda completa rappresenta la scelta migliore.
Il slicing della GPU influisce sulle prestazioni di un LLM?
Sì, in modo significativo. L’inferenza di un LLM è vincolata dalla banda passante della memoria e una slice riceve solo una frazione di essa. I token al secondo diminuiscono all’incirca proporzionalmente alla dimensione della slice.
Le GPU Trooper.AI vengono mai condivise?
No. Ogni Blib riceve interamente GPUs bare-metal dedicati, core CPU e RAM. Nulla viene suddiviso o condiviso con altri clienti.
Qual è il primo passo migliore?
Verifichi quanta VRAM richiede il Suo modello, quindi scelga il Blib full-card più piccolo che si adatti. Otterrà l’intera GPU e potrà effettuare un upgrade in seguito senza dover reinstallare.
Ultimo aggiornamento: settembre 2026. Confrontato su offerte pubblicamente elencate di fornitori europei di data center classici (settembre 2026), configurati con identici CPU, RAM e archiviazione rispetto al corrispondente Trooper.AI Blib. Fatturazione mensile. Le valutazioni di velocità sono basate sulla nostra analisi di CUDA cores, banda memoria, architettura e benchmark TAIFlops.
Cosa sta aspettando Lei?
Noleggi il Suo GPU Server oggi e inizi a creare applicazioni AI straordinarie! I Trooper.AI GPU servers sono costruiti con tecnologia high-end completamente riciclata degli ultimi anni, progettati per offrirLe le migliori prestazioni, sicurezza e affidabilità per tutte le Sue esigenze di intelligenza artificiale.
Noleggi un GPU Server per l'AI
EU location · Alta privacy · Great performance · Best support