Addestrare e Affinare Modelli di Intelligenza Artificiale in Maniera Sicura in Europa
Le aziende europee cercano sempre più infrastrutture GPU che combinano prestazioni elevate, certezza legale e flessibilità operativa. Piattaforme come Trooper.AI offrono macchine dedicate con GPU ospitate in data center dell’UE e gestite dalla Germania.
Questo consente alle squadre di addestrare modelli AI, perfezionare architetture esistenti o eseguire workload di inferenza mantenendo dataset sensibili all'interno dei quadri regolamentari europei come GDPR e il Regolamento sull’IA dell’UE.
🚀 Potenza GPU Dedicata Senza Limitazioni del Cloud Condiviso
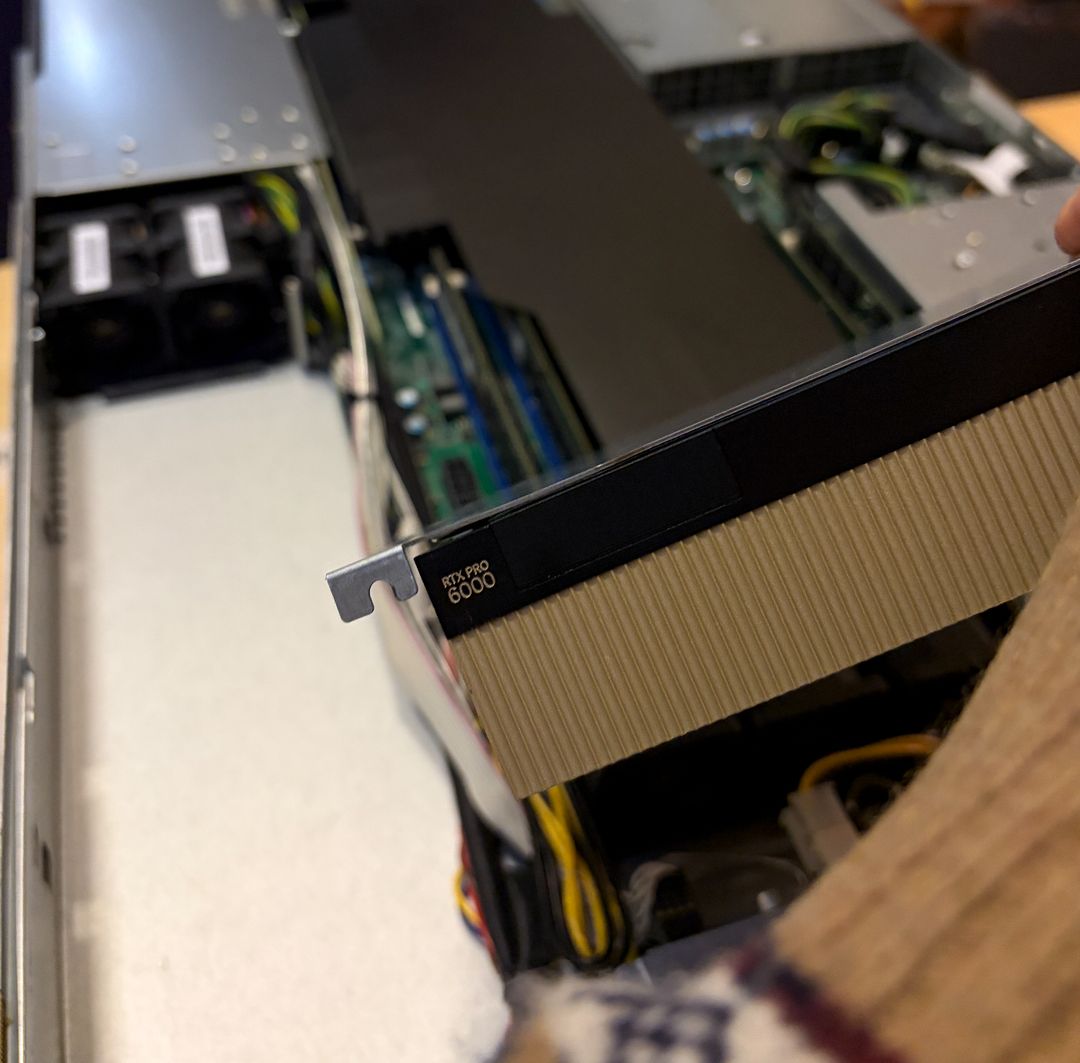
I carichi di lavoro AI moderni richiedono un accesso diretto alle prestazioni della GPU. Negli ambienti cloud condivisi, le prestazioni possono fluttuare a causa di contenzione delle risorse.
Trooper.AI offre prestazioni bare-metal di GPU, il che significa che le risorse GPU, CPU e RAM sono interamente dedicate a un singolo utente.
Questa architettura è ideale per workloads come:
- Addestramento e affinamento Large Language Models
- Esecuzione di LLM open-source come Llama o Qwen
- Stable Diffusion e intelligenza artificiale generativa
- Modelli di embedding e pipeline di ricerca vettoriale
- Ricerca in data science e machine learning
- carichi di lavoro HPC e simulazioni scientifiche
Gli sviluppatori ricevono accesso root completo, consentendo il pieno controllo su framework, dipendenze e dataset.
Infrastruttura di Grado Enterprise — Accessibile a Tutti
L'infrastruttura Trooper.AI supporta sia progetti AI aziendali che sviluppatori indipendenti.
Le squadre aziendali traggono vantaggio da:
- Cluster dedicati GPU per l’addestramento o l’inferenza
- Infrastruttura ospitata nell’UE per workload sensibili alla conformità
- Archiviazione persistente e snapshot completi della macchina
- Prestazioni bare-metal prevedibili
- Integrazione tramite API e interfaccia di gestione
Nel contempo, la piattaforma rimane accessibile per startup, ricercatori e sviluppatori indipendenti.
Invece di richiedere contratti aziendali di grandi dimensioni, i sviluppatori possono semplicemente dispiegare un server privato di GPU e iniziare a costruire immediatamente.
Iniziare con poco: GPU Server economici per lo sviluppo di intelligenza artificiale
Non ogni progetto di intelligenza artificiale inizia con cluster massivi o budget elevati. Molti modelli possono essere addestrati o affinati in modo efficiente su sistemi GPU più piccoli.
Trooper.AI offre server GPU entry-level progettati per sperimentazione e sviluppo, utilizzando GPU professionali e di data-center come:
- NVIDIA V100 (16–32 GB)
- RTX A4000 16 GB
- RTX Pro 4500 / serie RTX Pro 4000
Queste configurazioni consentono agli sviluppatori di:
- Sperimentare con il fine-tuning di modelli LLM
- Addestrare modelli transformer più piccoli
- Costruire applicazioni e prototipi AI
- Eseguire pipeline di Stable Diffusion o ComfyUI
Poiché l’infrastruttura utilizza hardware di alta gamma rigenerato, i costi rimangono significativamente inferiori rispetto a molte piattaforme cloud GPU tradizionali, mantenendo al contempo prestazioni moderne.
Questo consente di avviare lo sviluppo serio di intelligenza artificiale anche con un piccolo budget mensile.
Scalare fino alla Potenza GPU di Livello Imprenditoriale
Man mano che i modelli e gli insiemi di dati crescono, le esigenze computazionali aumentano rapidamente. Trooper.AI consente una scalabilità fluida verso configurazioni più potenti.
I tipi di GPU disponibili includono acceleratori ad alte prestazioni come:
- NVIDIA A100 40 GB
- NVIDIA V100 32 GB NVLINK
- RTX Pro 6000 Blackwell 96 GB
- RTX 4090 Pro 48 GB
- RTX 4080 Super Pro 32 GB
Queste GPU supportano workload AI su larga scala, inclusi training e inferenza per architetture avanzate di modelli linguistici (LLM) e pipeline complessi di intelligenza artificiale generativa.
Le squadre possono iniziare con una singola GPU e successivamente passare a sistemi multi-GPU per esecuzioni di addestramento più grandi senza dover ricostruire il proprio ambiente.
Inizi con Piccole Dimensioni, Scali secondo le Sue Esigenze
I GPU Server sono progettati per una vasta gamma di esigenze. Offrono risorse scalabili per adattarsi alle mutevoli richieste dei progetti.
Ambienti di Sviluppo AI Istantanei
La preparazione di una macchina GPU per carichi di lavoro AI può richiedere ore o giorni. Trooper.AI semplifica il deployment tramite modelli AI one-click che installano ambienti completamente configurati.
Gli sviluppatori possono avviare strumenti come:
- OpenWebUI e Ollama per l'interazione locale con LLM
- Jupyter Notebook per la ricerca in ambito di machine learning
- ComfyUI o A1111 per la generazione di immagini
- Ubuntu Desktop con accelerazione GPU
- n8n per l'automazione dei flussi di lavoro
Ogni modello installa automaticamente driver, dipendenze e punti di accesso sicuri.
Gli sviluppatori possono iniziare l’allenamento o l’esperimentazione con l’AI in pochi minuti invece di impiegare tempo nella configurazione dell’infrastruttura.
Utilizzo flessibile: sospendere i server per controllare i costi
I carichi di lavoro AI si eseguono spesso a scatti — lunghe sessioni di training seguite da periodi di inattività.
Trooper.AI consente agli utenti di sospendere o congelare i server GPU in qualsiasi momento. Lo stato completo della macchina è preservato, inclusi i modelli installati e gli insiemi di dati.
Ciò consente ai team di:
- Arresti le macchine al termine degli esperimenti
- Riprenda più tardi esattamente da dove aveva interrotto
- Evitare di pagare per infrastrutture inattive
Il risultato sono costi GPU prevedibili e gestibili.
Costruito in Europa per Progetti di Intelligenza Artificiale Sensibili alla Privacy
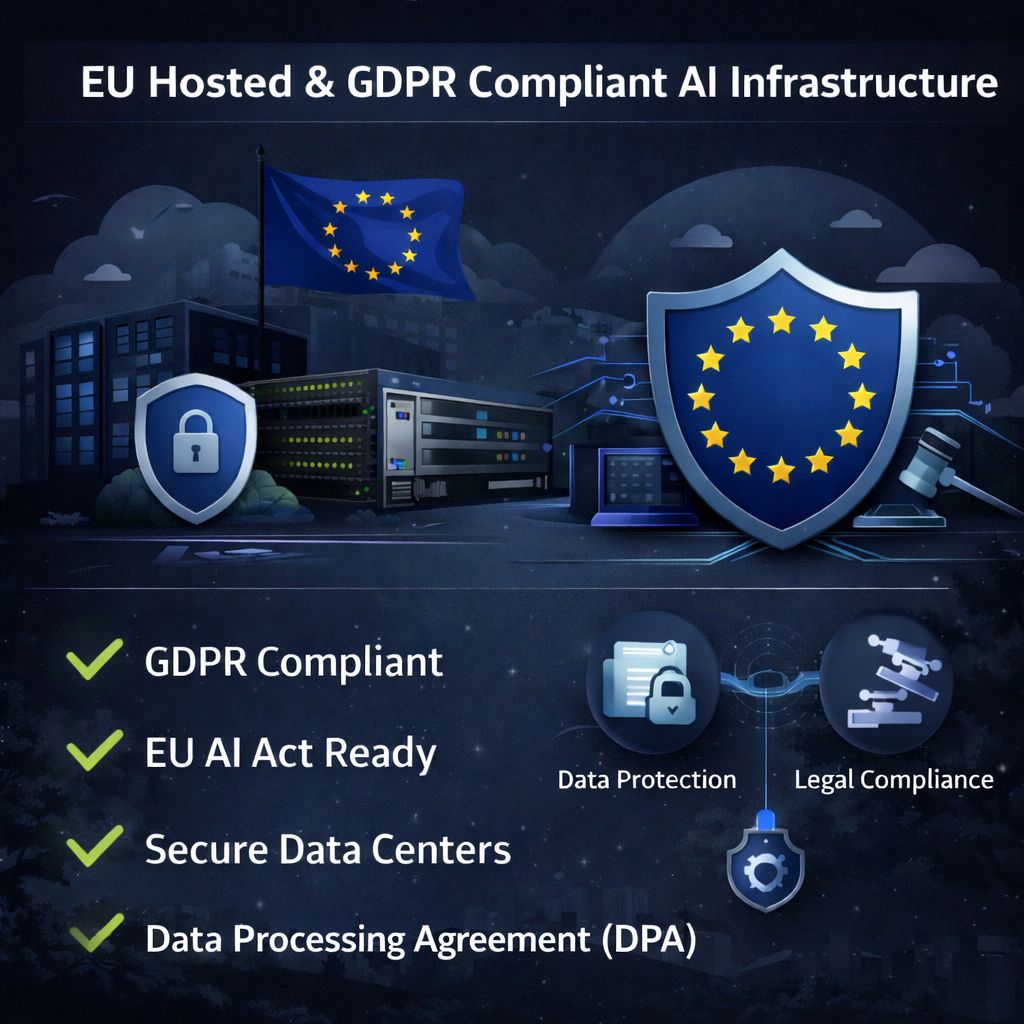
Tutta l'infrastruttura Trooper.AI opera in data centers europei ed è gestita dalla Germania.
Questa architettura supporta le organizzazioni che richiedono conformità normativa rigorosa o sovranità dei dati.
Principi chiave includono:
- infrastruttura ospitata nell’UE
- conformità al GDPR
- prontezza per l'EU AI Act
- Ambienti di data center enterprise-grade
- Punti di accesso sicuri e protezione SSL
Per le organizzazioni che lavorano con dataset sensibili, mantenere il pieno controllo su dove i dati vengono elaborati è fondamentale.
Infrastruttura GPU Sostenibile
Trooper.AI segue una filosofia infrastrutturale diversa rispetto a molti fornitori di cloud. Invece di sostituire costantemente l'hardware, la piattaforma si affida a sistemi GPU high-end rigenerati.
Queste macchine combinano:
- CPU di fascia enterprise come AMD EPYC o Intel Xeon
- GPU professionali e per data center
- Archiviazione NVMe ad alta velocità
- Rete ad alta capacità
Questo approccio garantisce elevate prestazioni riducendo al contempo i rifiuti elettronici e l’impatto ambientale.
Infrastruttura AI per Costruttori
Trooper.AI è stato creato con una semplice idea: un'infrastruttura GPU potente dovrebbe essere accessibile a chiunque stia costruendo l'AI.
Che Lei sia:
- Un’azienda che addestra modelli proprietari
- Una startup che sviluppa prodotti di AI
- Un team di ricerca che esegue esperimenti
- Uno sviluppatore che esplora l'AI generativa
Lei può dispiegare un privato GPU server in pochi minuti e iniziare a lavorare immediatamente.
Cosa sta aspettando Lei?
Noleggi il Suo GPU Server oggi e inizi a creare applicazioni AI straordinarie! I Trooper.AI GPU servers sono costruiti con tecnologia high-end completamente riciclata degli ultimi anni, progettati per offrirLe le migliori prestazioni, sicurezza e affidabilità per tutte le Sue esigenze di intelligenza artificiale.
Noleggi un GPU Server per l'AI
EU location · Alta privacy · Great performance · Best support