Čo je GPU slicing?
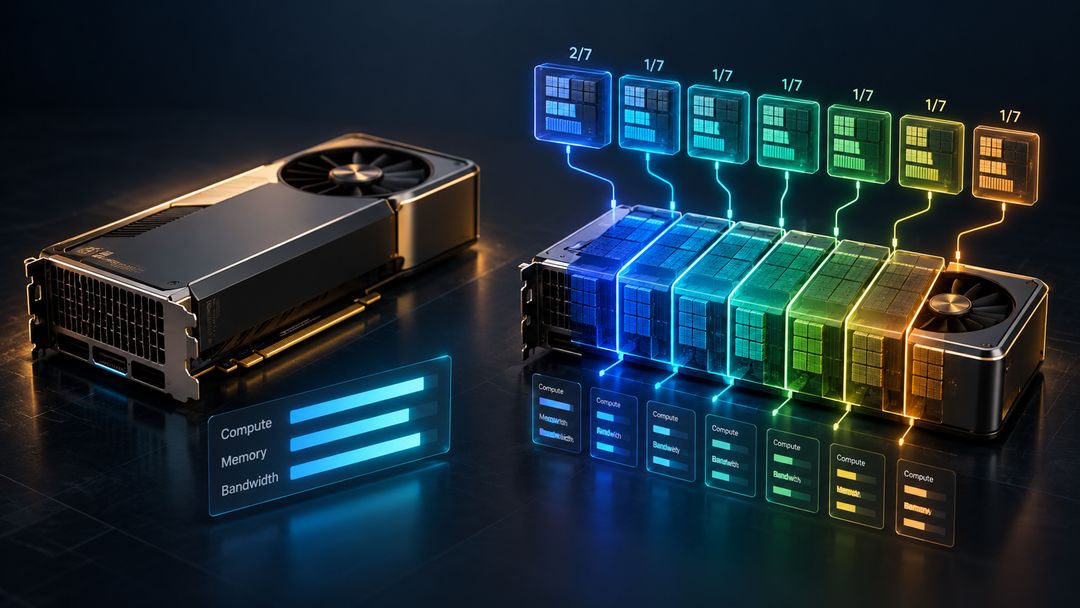
GPU slicing rozdeli jednu fyzickú grafickú kartu na viac menších virtuálnych GPU. Každý rezeň dostáva pevný podiel VRAM a len zlomok počtových jednotiek karty a pásma pamäťového prenosu.
Na kartách datových centier sa to obvykle robí pomocou MIG (Multi-Instance GPU). Karta A100 alebo H200 sa dá rozdeliť na maximálne sedem inštancií, pričom každá dostane pevné oddelenie prúdových multiprocesorov a pamäte. Názov to odhaluje: profil „1g.10gb“ je 1/7 čipu s 10 GB VRAM.
Pre dodávateľov je slicing skvelý spôsob, ako vyplniť racky. Pre Vás to znamená niečo jednoduché: používate názov veľkého GPU, ale len jeho časť výkonu.
⚡ Prečo vás slicing spomaľuje
Tri veci sa zmenšujú, keď je GPU rozrezané:
- CUDA jádra. Pri 2/7 reze karty A100 dostanete 1 792 jej jadier, nie 6 912.
- Pásmová šírka pamäte. Inference LLM je omezené pásmovou šírkou. Režie dostane zodpovedajúci zlomok pamäťového kanála, takže tokens za sekundu prudko klesá.
- VRAM. Dostanete presne pamäť podľa veľkosti reza. Veľké modely, dlhšie kontexty a väčšie bátče jednoducho nezmestia.
Plná, menšia grafická karta často prevyšuje rozdelenú, väčšiu kartu. Moderná Blackwell karta s všetkými svojimi jadrami je rýchlejší než známa grafická karta z datového centra rozdelená na sedminy.
📊 Porovnanie: Klasické GPU v datových centrách vs. Trooper.AI Blibs
Porovnali sme typické ponuky z európskych klasických datových centier s odpovedajúcimi Trooper.AI Blibs. Každý Blib má aspoň rovnakú VRAM. Pre spravodlivé porovnanie cien sa každá klasická ponuka konfigurovala s prísne rovnakými CPU jadrami, RAM a NVMe úložiskom ako ten Blib, s ktorým sa porovnáva.
| Klasický GPU datového centra | VRÁM | CUDA jádra (Klasické) | Trooper.AI Blib | VRÁM | CUDA jádra (Trooper.AI) | rýchlosť | Cena |
|---|---|---|---|---|---|---|---|
| T4 – 1/4 reza | 4 GB | ~640 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Rýchlejší | až o 56% lacnejšie |
| T4 – polovicná časť | 8 GB | ~1,280 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Rýchlejší | až o 64% lacnejšie |
| T4 – celý | 16 GB | 2,560 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Rýchlejší | až o 74 % lacnejšie |
| A10 – 1/6 reza | 4 GB | ~1,536 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Rýchlejší | až o 61 % lacnejšie |
| A10 – 1/3 reza | 8 GB | ~3,072 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Rýchlejší | až o 70 % lacnejšie |
| A10 – polovicná časť | 12 GB | ~4,608 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Rýchlejší | až o 76 % lacnejšie |
| A10 – celý | 24 GB | 9,216 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Rýchlejší | až o 73 % lacnejšie |
| A100 – 1/7 reza | 10 GB | 896 | Explorer S1 · RTX A4000 | 16 GB | 6,144 | Rýchlejší | až o 69% lacnejšie |
| A100 – 2/7 reza | 20 GB | 1,792 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Rýchlejší | až o 65 % lacnejšie |
| A100 – 3/7 reza | 40 GB | 2,688 | InfinityAI S1 · A100 (plná grafická karta) | 40 GB | 6,912 | Rýchlejší | až o 61 % lacnejšie |
| A100 – 7/7 slice | 80 GB | 6,272 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Rýchlejší | až o 36% lacnejšie |
| L40S – plný | 48 GB | 18,176 | StellarAI L1 · RTX 4090 Pro | 48 GB | 16,384 | Rýchlejší | až o 32% lacnejšie |
| H200 – 1/7 režie | 20 GB | 2,048 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Rýchlejší | až o 65 % lacnejšie |
| H200 – 2/7 reza | 40 GB | 4,096 | InfinityAI S1 · A100 (plná grafická karta) | 40 GB | 6,912 | Rýchlejší | až o 67 % lacnejšie |
| H200 – 3/7 reza | 70 GB | 7,680 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Rýchlejší | až o 36% lacnejšie |
| H200 – celý | 141 GB | 16,896 | HyperionAI M2 · 2× RTX Pro 6000 Blackwell | 192 GB | 48,128 | Rovnaká rýchlosť | až o 40 % lacnejšie |
| RTX Pro 6000 – 1/2 slice | 48 GB | ~12,032 | RabenAI S1 · RTX Pro 5000 Blackwell (plná grafická karta) | 48 GB | 14,080 | Rýchlejší | až o 37 % lacnejšie |
Zrezaný GPU dostáva len zlomok čipu: má menej CUDA jadier, zhodný zlomok šírky pásma pamäte a svoj podiel VRAM. Trooper.AI Blib vždy dostáva celú kartu.
🔍 Čo tabuľka vyjadruje
1. Režie nie je GPU. „A100 s 20 GB“ ako 2/7 režie dostáva menej ako tretinu čipu. Naša Ranger S1 s plnou grafickou kartou RTX Pro 4000 Blackwell má päťkrát viac CUDA jadier, viac VRAM a stála až o 65 % menej.
2. Celé grafické karty vyhrávajú v prenosovej šírke pásma. Inference modelov LLM závisí od pamäťovej prenosovej šírky pásma. Režie dostáva len zlomok z nej, celá grafická karta dostáva všetko. Preto plná A100 alebo RTX Pro 5000 pravidelne predbehne o veľa väčšiu GPU, ktorá bola rozdelená na časti.
3. Blackwell zmenil matematiku. Piata generácia Tensor Cores s rodinným FP4 a FP8 umožňuje jedinému RTX Pro 6000 Blackwell prebehnúť aj plne alokovanú grafickú kartu A100 s 80 GB na súčasných kvantizovaných modeloch, s 16 GB viac VRAM.
4. Aj H200 prehráva, keď je nakrájaný. Režie 3/7 má menej ako polovicu streaming multiprocessorov a polovicu šírky pásma pamäte, a nemá rodilé FP4. Plný RTX Pro 6000 Blackwell ho prevyšuje v súčasných kvantizovaných modeloch, s 26 GB viac VRAM a až o 36 % nižšou cenou. Len plný, nenakrájaný H200 sa vyrovná dvojam kartám HyperionAI, ktoré ponúkajú 192 GB VRAM namesto 141 GB.
5. L40S je spravodlivý súboj, a my stále víťazíme. Oproti plnému L40S náš RTX 4090 Pro 48 GB ponúka vyšší šírku pásma pamäte (okolo 1 TB/s oproti 864 GB/s), čo je rozhodujúce pri inferencii LLM, a to až o 32 % nižšej cene.
💸 Skrytý náklad „levných“ rezólcov
Samotný rezeň často vypadá lacno. Účet nie je. Klasické datové centrá typicky účtujú za každý vCore, za každý gigabajt RAM a za každý gigabajt úložiska zvlášť. Konfigurácia reznia s dostatočným RAM na skutočné načítanie vašej modeli zvyšuje cenu rýchlo.
Realistická AI úloha vyžaduje systémový RAM aspoň rovnaký ako jej VRAM, dostatok CPU jadier na tokenizáciu a načítanie dát, ako aj rýchly lokálny úložisko pre váhy modelu. Keď prídete o tieto prvky, zrezaná GPU je zriedkavo lacnou možnosťou.
| Kostový faktor | Klasický rezeň datového centra | Trooper.AI Blib |
|---|---|---|
| GPU | Časť karty | Plná grafická karta, bare-metal |
| CPU jádra | Fakturované za vCore | Zahrnuté, vyčlenené |
| RAM | Zúčtované za GB | Zahrnuté, vyčlenené |
| Úložište | Často sieťovo pripojené, fakturované za GB | Lokálne NVMe až do 7,5 GB/s, zahŕnuté |
| Nastavovacie poplatky | Bežné pri ponukách s bare-metalom | Žiadne |
| Fakturácia | Často mesačne alebo na dlhšie obdobie | hodinovo, týždenne alebo mesačne |
🇪🇺 Ako Trooper.AI Vám poskytuje celú GPU
Trooper.AI prenajímá GPU stroje hostované v EU, spravované z Nemecka, s plnými bare-metalovými GPU vo všetkých Bliboch. Žiadne rozdelenie, žiadny zdieľaný silícium, žiadni rušiví susedi na Vašej grafike. Od RTX A4000 po štyri karty RTX Pro 6000 Blackwell s 384 GB VRAMu, Vám je vždy k dispozícii celý GPU.
Hlavné výhody zahŕňajú:
- ✅ 100% bare-metal GPU, plná kapacita CPU a RAM
- ✅ Lokálne NVMe úložište s rýchlosťou až 7,5 GB/s
- ✅ 99,6% dostupnosť SLA pre obchodných zákazníkov
- ✅ Hostované v EU, GDPR DPA podpísané jedným kliknutím
- ✅ Plný root prístup a šablóny umelnej inteligencie s jedným kliknutím (vLLM, OpenWebUI, ComfyUI a viac)
- ✅ Fakturácia za hodinu, týžden alebo mesiac, plus rezervovaná kapacita Blackwell
Konfigurujte svoj plný GPU server teraz →
Často kladené otázky
Čo je rozrezaný GPU?
Rozrezaná GPU je zlomok fyzickej grafickej karty, typicky vytvorený pomocou MIG alebo vGPU profilov. Dostanete si pevný podiel z VRAM a len zlomok CUDA jadier a pásma pamäťového prenosu.
Je rozrezaná grafická karta A100 alebo H200 rýchlejšia ako plná súčasná GPU?
Obvykle nie. Čiastka 1/7 alebo 2/7 obsahuje len malú časť pôvodného čipu. Plná súčasná grafická karta, ako napríklad RTX Pro 4000 alebo RTX Pro 6000 Blackwell, poskytuje viac CUDA jadier, vyšší prenosovú šírku a rodinnú podporu pre FP4/FP8.
Kedy má zmysel používať slice?
Pre veľmi malé, nárazové úlohy inferencie alebo virtuálne pracovné stoly, kde stačí zlomok GPU. Pre inferenciu LLM, fine-tuning alebo generovanie obrazov je lepšou volbou plná grafická karta.
Ovplyvňuje GPU slicing výkon LLM?
Áno, významne. Inference LLM je omezené šírkou pásma pamäte a slice dostane len zlomok z nej. Tokens za sekundu klesajú približne v súlade s veľkosťou slice.
Sú GPU od Trooper.AI niekedy zdieľané?
Nie. Každý Blib dostáva plné, vyhradené bare-metal GPU, CPU jadrá a RAM. Nič nie je rozdelené alebo sdielané s ostatnými zákazníkmi.
Aký je najlepší prvý krok?
Overte si, koľko VRAM váš model potrebuje, potom vyberte najmenší celokartový Blib, ktorý sa vám hodí. Dostanete celú GPU a neskôr môžete bez reinštalácie upgradovať.
Posledné aktualizované: september 2026. Porovnanie je založené na verejne zverejnených ponukách európskych klasických poskytovateľov datových centier (september 2026), konfigurovaných s identickým CPU, RAM a úložiskom ako príslušný Trooper.AI Blib. Mesičné fakturovanie. Hodnotenie rýchlosti je naša odhadnutá hodnota založená na CUDA jadrách, pásme pamäte, architektúre a našich vlastných TAIFlops benchmarkoch.
ČO SA ČAKÁŠ?
Vypožičajte si vlastný GPU server dnes a začnite budovať úžasné aplikácie umelnej inteligencie! Servre Trooper.AI sú postavené z čisto recyklovaných vysokokapacitných technológií z posledných rokov, navrhnutých tak, aby vám poskytovali najlepšiu výkonnosť, bezpečnosť a spoľahlivosť pre všetky vaše potreby v oblasti AI.
Ponajmite GPU server pre umelú inteligenciu
Lokácia v EÚ · Vysoká ochrana súkromia · Výborný výkon · Najlepšia podpora