Hvad er GPU-slicing?
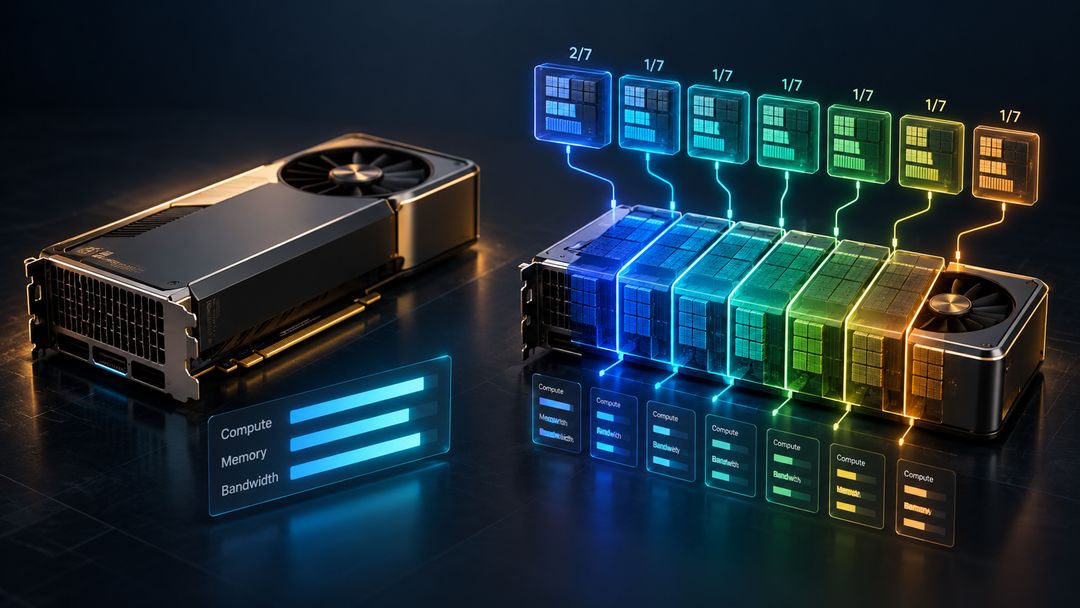
GPU-slicing opdeler en fysisk grafikkort i flere mindre virtuelle GPUs. Hver skive får en fast andel af VRAM’en og kun en brøkdel af kortets beregningsenheder og hukommelsesbåndbredde.
På datacenter-kort udføres dette normalt med MIG (Multi-Instance GPU). En A100 eller H200 kan deles op i op til syv instanser, og hver får en fast partition af streaming multiprocessors og hukommelse. Navnet afslører det: et «1g.10gb»-profil er 1/7 af chipset med 10 GB VRAM.
For leverandører er slicing en fantastisk måde at fylde rackene på. For dig betyder det noget simpelt: du lejer navnet på en stor GPU, men kun en del af dens ydeevne.
⚡ Hvorfor slicing koster dig hastighed
Tre ting mindskes, når en GPU er opdelt:
- CUDA-kerner. En 2/7-slice af en A100 får 1.792 af dens kerner, ikke 6.912.
- Hukommelsesbåndbredde. LLM-inference er begrænset af båndbredden. En skive får en tilsvarende brøkdel af hukommelsesbus, så tokens pr. sekund falder markant.
- VRAM. Du får præcis den del af maskinens hukommelse, som slicen giver. Større modeller, længere kontekster og større batch-størrelser passer simpelthen ikke.
En fuld, mindre kort slår ofte en skåret, større én. En moderne Blackwell-kort med alle sine kerner er hurtigere end en kendt datacenter-GPU skåret i syvendedele.
📊 Sammenligning: Klassiske datacenter-GPUs vs. Trooper.AI Blibs
Vi har sammenlignet typiske tilbud fra europæiske klassiske datacentre med de tilsvarende Trooper.AI Blibs. Hver Blib har mindst samme VRAM. For en retfærdig pris sammenligning blev hvert klassisk tilbud konfigureret med præcis de samme CPU-kerner, RAM og NVMe-lagring som den Blib, det sammenlignes med.
| klassisk datacenter-GPU | VRAM | CUDA-kerner (klassisk) | Trooper.AI Blib | VRAM | CUDA-kerner (Trooper.AI) | hastighed | Pris |
|---|---|---|---|---|---|---|---|
| T4 – 1/4 del | 4 GB | ~640 | Trooper S1 · RTX A4000 | 16 GB | 6,144 | Hurtigere | op til 56% billigere |
| T4 – halvdelen af en Blib | 8 GB | ~1,280 | Trooper S1 · RTX A4000 | 16 GB | 6,144 | Hurtigere | op til 64% billigere |
| T4 – hel | 16 GB | 2,560 | Trooper S1 · RTX A4000 | 16 GB | 6,144 | Hurtigere | op til 74% billigere |
| A10 – 1/6 del | 4 GB | ~1,536 | Trooper S1 · RTX A4000 | 16 GB | 6,144 | Hurtigere | op til 61% billigere |
| A10 – 1/3 slice | 8 GB | ~3,072 | Trooper S1 · RTX A4000 | 16 GB | 6,144 | Hurtigere | op til 70% billigere |
| A10 – ½ del | 12 GB | ~4,608 | Trooper S1 · RTX A4000 | 16 GB | 6,144 | Hurtigere | op til 76% billigere |
| A10 – hel | 24 GB | 9,216 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Hurtigere | op til 73% billigere |
| A100 – 1/7 slice | 10 GB | 896 | Trooper S1 · RTX A4000 | 16 GB | 6,144 | Hurtigere | op til 69% billigere |
| A100 – 2/7-slice | 20 GB | 1,792 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Hurtigere | op til 65% billigere |
| A100 – 3/7 del | 40 GB | 2,688 | InfinityAI S1 · A100 (hele kort) | 40 GB | 6,912 | Hurtigere | op til 61% billigere |
| A100 – fuld kort | 80 GB | 6,272 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Hurtigere | op til 36% billigere |
| L40S – fuld | 48 GB | 18,176 | StellarAI L1 · RTX 4090 Pro | 48 GB | 16,384 | Hurtigere | op til 32 % billigere |
| H200 – 1/7 del | 20 GB | 2,048 | Ranger S1 · RTX Pro 4000 Blackwell | 24 GB | 8,960 | Hurtigere | op til 65% billigere |
| H200 – 2/7 del | 40 GB | 4,096 | InfinityAI S1 · A100 (hele kort) | 40 GB | 6,912 | Hurtigere | op til 67% billigere |
| H200 – 3/7 del | 70 GB | 7,680 | HyperionAI S1 · RTX Pro 6000 Blackwell | 96 GB | 24,064 | Hurtigere | op til 36% billigere |
| H200 – hel | 141 GB | 16,896 | HyperionAI M2 · 2× RTX Pro 6000 Blackwell | 192 GB | 48,128 | Lige hastighed | op til 40% billigere |
| RTX Pro 6000 – halveret | 48 GB | ~12,032 | RabenAI S1 · RTX Pro 5000 Blackwell (hele kort) | 48 GB | 14,080 | Hurtigere | op til 37% billigere |
En skåret GPU får kun en brøkdel af chippen: færre CUDA cores, en tilsvarende brøkdel af hukommelsesbåndbredde og en del af VRAM'en. En Trooper.AI Blib får altid hele kortet.
🔍 Hvad tabellen fortæller dig
1. En skive er ikke en GPU. En «A100 med 20 GB» som en 2/7-skive får mindre end en tredjedel af chippen. Vores Ranger S1 med en fuld RTX Pro 4000 Blackwell har fem gange så mange CUDA-kerner, mere VRAM og koster op til 65% mindre.
2. Helkort vinder på båndbredde. LLM-inference afhænger af hukommelsesbåndbredde – det er liv og død for det. En skive får kun en brøkdel af båndbredden, mens et helkort får al tilgang. Derfor overgår et helt A100 eller RTX Pro 5000 ofte en meget «større» GPU, der er blevet delt op i stykker.
3. Blackwell ændrer regnskabet. Femte generations Tensor Cores med indbygget FP4 og FP8 giver en enkelt RTX Pro 6000 Blackwell mulighed for at overgå endda en fuldt allokeret 80 GB A100 på moderne kvantiserede modeller, med 16 GB mere VRAM.
4. Selv H200 taber, når den er skåret op. En 3/7-skive har mindre end halvdelen af streaming-multiprocessorerne og halvdelen af hukommelsesbåndbredden, og ingen indbygget FP4. En fuld RTX Pro 6000 Blackwell overgår den på moderne kvantiserede modeller med 26 GB mere VRAM og op til 36% lavere omkostninger. Kun en fuld, uskåret H200 er på niveau med to HyperionAI-kort, og de giver dig 192 GB i stedet for 141 GB.
5. En fuld L40S er en retfærdig kamp, og vi vinder stadig. Mod en fuld L40S leverer vores RTX 4090 Pro 48 GB højere hukommelsesbåndbredde (ca. 1 TB/s vs. 864 GB/s), hvilket er afgørende for LLM-inference, til op til 32% lavere omkostninger.
💸 De skjulte omkostninger ved "billige" maskinestykker
Selve skiven ser ofte tilbudsvenlig ud. Regningen gør det ikke. Klassiske datacentre fakturerer typisk separat for hver vCore, hvert gigabyte RAM og hvert gigabyte lagring. Konfigurer en skive med nok RAM til at løbe din model, og prisen stiger hurtigt.
En realistisk AI-belastning kræver system-RAM mindst ligeså stort som dens VRAM, tilstrækkelige CPU-kerner til tokenisering og dataindloading samt hurtig lokal lagring til modelvægte. Når du tilføjer dem, er en sliced GPU sjældent det billigste valg.
| Kostfaktor | Klassisk datacenter-slice | Trooper.AI Blib |
|---|---|---|
| GPU | Del af en card | Helt kort, bare-metal |
| CPU-kerner | Debiteret pr. vCore | Medtaget, dedikeret |
| RAM | Debiteret pr. GB | Medtaget, dedikeret |
| Lagring | Ofte netværksmonteret, debiteres pr. GB | Lokal NVMe op til 7,5 GB/s, inkluderet |
| Opsætningsgebyrer | Almindelig på bare-metal-tilbud | Ingen |
| Abonnement | Ofte månedligt eller på lange kontrakter | Timevis, ugentlig eller månedligt |
🇪🇺 Sådan giver Trooper.AI dig hele GPU’en
Trooper.AI lejer EU-hostede GPU-maskiner, drevet fra Tyskland, med fulde, bare-metal-GPUs i hver Blib. Ingen opskæring, ingen delt hardware, ingen støjende naboer på din kort. Fra en RTX A4000 til fire RTX Pro 6000 Blackwell-kort med 384 GB VRAM får du altid den fulde GPU.
Vigtigste fordele inkluderer:
- ✅ 100% bare-metal GPU, CPU og RAM
- ✅ Lokalt NVMe-lager med op til 7,5 GB/s
- ✅ 99,6 % tilgængelighed SLA for erhvervskunder
- ✅ EU-vært, GDPR DPA underskrevet på et klik
- ✅ Fuld root-adgang og AI-skabeloner med ét klik (vLLM, OpenWebUI, ComfyUI og mere)
- ✅ Timeligt, ugentligt eller månedligt faktura, plus reserveret Blackwell-kapacitet
Konfigurer din fulde GPU-maskine nu →
Ofte stillede spørgsmål
Hvad er en sliced GPU?
En sliced GPU er en brøkdel af et fysisk grafikkort, typisk oprettet med MIG eller vGPU-profiler. Du får en fast andel af VRAM’en og kun en brøkdel af CUDA-kernerne og hukommelsesbåndbredden.
Er en skåret A100 eller H200 hurtigere end en fuld moderne GPU?
Normalt ikke. En 1/7 eller 2/7-slice har kun en lille del af den originale chip. Et fuldt, moderne kort som RTX Pro 4000 eller RTX Pro 6000 Blackwell leverer flere CUDA-kerner, mere båndbredde og naturligt FP4/FP8-støtte.
Hvornår giver en slice mening?
Til meget små, kortvarige inferencemål eller virtuelle skrivebordsløsninger, hvor en brøkdel af en GPU er tilstrækkelig. Til LLM-inference, finjustering eller billedegenerering er et fuldt kort det bedste valg.
Påvirker GPU-slicing ydeevnen af LLM?
Ja, betydeligt. LLM-inference er begrænset af hukommelsesbåndbredde, og en slice får kun en brøkdel af det. Tokens pr. sekund falder groft set i takt med slice-størrelsen.
Bliver Trooper.AI GPUs nogensinde delt?
Nej. Hver Blib får fuld adgang til dedikerede bare-metal GPUs, CPU-kerner og RAM. Intet er opdelt eller delt med andre kunder.
Hvad er det bedste første skridt?
Tjek, hvor meget VRAM din model har brug for, og vælg derefter den mindste fuldkort-Blib, der passer. Du får hele GPU’en og kan opgradere senere uden geninstallation.
Senest opdateret: september 2026. Sammenligning baseret på offentligt opførte tilbud fra europæiske klassiske datacenter-leverandører (september 2026), konfigureret med identisk CPU, RAM og lagring som den tilsvarende Trooper.AI Blib. Månedlig fakturering. Hastighedsvurderinger er vores bedømmelse baseret på CUDA-kerner, hukommelsesbåndbredde, arkitektur og vores egne TAIFlops-benchmarks.
HVAD VENTER DU PÅ?
Lej din egen GPU-server i dag og begynd at bygge fantastiske AI-applikationer! Trooper.AI GPU-servere er bygget af udelukkende opcyklet high-end teknologi fra de seneste år, designet til at give dig den bedste ydeevne, sikkerhed og pålidelighed til alle dine AI-behov.
Lej en GPU-server til AI
EU-placering · Høj privatlivsbeskyttelse · Fantastisk ydeevne · Bedste support