Enten du allerede kører en GPU-server og vil servere en model med vLLM på den, eller er ny og ønsker at komme i gang med privat, EU-hospiteret LLM-inference – så er denne én-klik-tjeneste til Privat LLM netop noget for dig.
- Enkelt klik-deploy: tryk på Start (timebaseret eller månedligt), og vi opsætter en GPU-server med forinstalleret vLLM ved hjælp af den præcis benchmarkede konfiguration til det pågældende model.
- Kun hvad der er tilgængeligt: Start aktiveres kun når den bedste GPU faktisk er ledig og kan udplaceres lige nu.
- Vurder kvaliteten først: åbn Vis responskvalitet for at læse reelle eksempler på svar pr. testkategori før du bekræfter.
| Model | Kontekst | Parallel t/s | Enkel t/s | Timebaseret | Månedligt | Konfiguration |
|---|---|---|---|---|---|---|
| Llama 3.3 70B 4-bit Perfect on sparbox.m2 | 12,288 | 68 | 35 | €0.70/h | €375.00/mo | sparbox.m2 |
| Qwen3 30B 4-bit Perfect on sparbox.m2 | 84,992 | 877 | 168 | €0.70/h | €375.00/mo | sparbox.m2 |
| Qwen3.6 27B 4-bit Perfect on sparbox.m2 | 69,632 | 396 | 66 | €0.70/h | €375.00/mo | sparbox.m2 |
| Qwen3.6 35B 4-bit Perfect on sparbox.m2 | 62,464 | 747 | 143 | €0.70/h | €375.00/mo | sparbox.m2 |
| Gemma 4 31B 4-bit Perfect on sparbox.m2 | 17,408 | 390 | 62 | €0.70/h | €375.00/mo | sparbox.m2 |
| Gemma 4 E2B Perfect on sparbox.sm1 More context, higher speed on sparbox.m2 | 76,800 | 914 | 133 | €0.38/h | €205.00/mo | sparbox.sm1 |
| 117,760 +52% | 1,160 +27% | 184 | €0.70/h | €375.00/mo | sparbox.m2 | |
| Gemma 4 E4B Perfect on sparbox.sm1 More context, higher speed on sparbox.m2 | 30,720 | 538 | 70 | €0.38/h | €205.00/mo | sparbox.sm1 |
| 95,232 +205% | 737 +37% | 104 | €0.70/h | €375.00/mo | sparbox.m2 | |
| Granite 4.1 8B Perfect on novatesla.s1 More context, higher speed on sparbox.m2 More context, higher speed on infinityai.s1 | 41,984 | 247 | 39 | €0.29/h | €155.00/mo | novatesla.s1 |
| 76,800 +80% | 556 +125% | 76 | €0.70/h | €375.00/mo | sparbox.m2 | |
| 69,632 +62% | 539 +118% | 69 | €0.62/h | €330.00/mo | infinityai.s1 | |
| Llama 3.1 8B Perfect on sparbox.m2 | 95,232 | 621 | 86 | €0.70/h | €375.00/mo | sparbox.m2 |
| Phi 4 Perfect on sparbox.m2 | 14,336 | 367 | 50 | €0.70/h | €375.00/mo | sparbox.m2 |
| Phi 4 multimodal Perfect on sparbox.m2 | 117,760 | 941 | 144 | €0.70/h | €375.00/mo | sparbox.m2 |
| Ministral 3 14B Perfect on sparbox.sm1 More context, higher speed on sparbox.m2 | 20,480 | 429 | 56 | €0.38/h | €205.00/mo | sparbox.sm1 |
| 84,992 +300% | 623 +45% | 89 | €0.70/h | €375.00/mo | sparbox.m2 | |
| Ministral 3 3B Perfect on sparbox.sm1 | 84,992 | 1,218 | 164 | €0.38/h | €205.00/mo | sparbox.sm1 |
| Mistral 7B Perfect on sparbox.sm1 | 28,672 | 399 | 53 | €0.38/h | €205.00/mo | sparbox.sm1 |
| Llama 3.1 8B 8-bit Perfect on ranger.s1 More context, higher speed on infinityai.s1 | 20,480 | 69 | 62 | €0.39/h | €210.00/mo | ranger.s1 |
| 117,760 +449% | 889 +1197% | 115 | €0.62/h | €330.00/mo | infinityai.s1 | |
| GPT OSS 20B Perfect on sparbox.m2 | 117,760 | 739 | 223 | €0.70/h | €375.00/mo | sparbox.m2 |
| Ornith 1.0 9B 4-bit Perfect on ranger.s1 | 52,224 | 78 | 59 | €0.39/h | €210.00/mo | ranger.s1 |
| Qwen3 Coder 30B 4-bit Perfect on sparbox.sm1 More context, higher speed on sparbox.m2 | 25,600 | 886 | 170 | €0.38/h | €205.00/mo | sparbox.sm1 |
| 84,992 +224% | 949 +7% | 167 | €0.70/h | €375.00/mo | sparbox.m2 | |
| Qwen3 VL 32B 4-bit Perfect on sparbox.m2 | 37,888 | 429 | 63 | €0.70/h | €375.00/mo | sparbox.m2 |
| Qwen2.5 32B 4-bit Perfect on sparbox.m2 | 28,672 | 438 | 64 | €0.70/h | €375.00/mo | sparbox.m2 |
| Qwen2.5 7B Perfect on sparbox.sm1 | 28,672 | 400 | 51 | €0.38/h | €205.00/mo | sparbox.sm1 |
| Qwen3 14B Perfect on sparbox.m2 | 36,864 | 364 | 50 | €0.70/h | €375.00/mo | sparbox.m2 |
| Qwen3 32B 8-bit Perfect on sparbox.m2 | 18,432 | 297 | 42 | €0.70/h | €375.00/mo | sparbox.m2 |
| Qwen3 4B Perfect on sparbox.sm1 | 36,864 | 627 | 85 | €0.38/h | €205.00/mo | sparbox.sm1 |
| Qwen3 4B (2507) Perfect on sparbox.sm1 More context, higher speed on infinityai.s1 | 58,368 | 626 | 84 | €0.38/h | €205.00/mo | sparbox.sm1 |
| 117,760 +100% | 918 +47% | 119 | €0.62/h | €330.00/mo | infinityai.s1 | |
| Qwen3 8B Perfect on sparbox.sm1 More context, higher speed on infinityai.s1 | 23,552 | 379 | 49 | €0.38/h | €205.00/mo | sparbox.sm1 |
| 36,864 +54% | 590 +56% | 75 | €0.62/h | €330.00/mo | infinityai.s1 | |
| Qwen3 Coder 30B 8-bit Perfect on sparbox.m2 | 41,984 | 812 | 153 | €0.70/h | €375.00/mo | sparbox.m2 |
| Qwen3 VL 32B 8-bit Perfect on sparbox.m2 | 15,360 | 294 | 41 | €0.70/h | €375.00/mo | sparbox.m2 |
| Qwen3 VL 4B Perfect on novatesla.s1 More context, higher speed on sparbox.m2 | 69,632 | 436 | 68 | €0.29/h | €155.00/mo | novatesla.s1 |
| 117,760 +69% | 874 +101% | 119 | €0.70/h | €375.00/mo | sparbox.m2 | |
| Qwen3.5 9B Perfect on sparbox.m2 | 95,232 | 558 | 82 | €0.70/h | €375.00/mo | sparbox.m2 |
| Qwen3.6 27B 8-bit Perfect on sparbox.m2 | 28,672 | 164 | 47 | €0.70/h | €375.00/mo | sparbox.m2 |
| Gemma 4 31B 8-bit Perfect on sparbox.m2 | 8,192 | 286 | 43 | €0.70/h | €375.00/mo | sparbox.m2 |
Kontext = maksimal anvendelig kontekstvindue. Parallel/Enkelt = tokens/sec. Priser afspejler den bedste pris-præstation GPU pr. model. Priser er forudbetalt; du beholder fuld root-adgang.
Vil du bare have en GPU-server?
Du behøver ikke at vælge en model her – bestil i stedet en ren GPU-server og kør hvad du vil på den med fuld root-adgang.
Bestil en GPU-serverDin vLLM-dashboard klar umiddelbart efter udplacering
Få sekunder efter du trykker på Start er din private model klar bag en OpenAI-kompatibel endpoint – overvåg gennemstrømning, kontekstbrug og anmodninger fra dit eget dashboard.
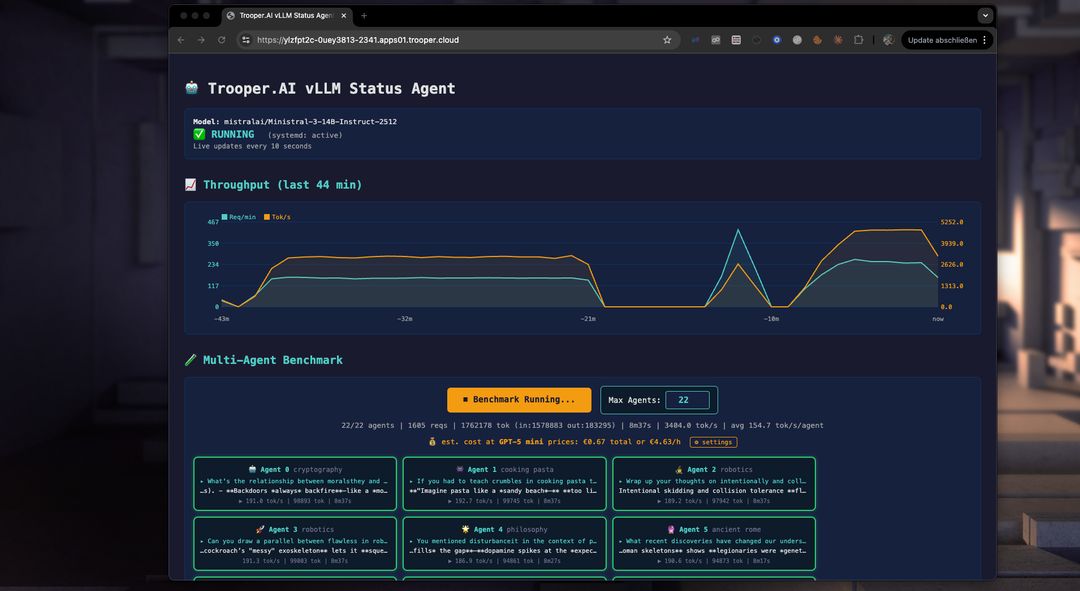
De top 10 funktioner i din private LLM-GPU-server
- Enkelt-klik vLLM-deploy — din model starter med den præcist benchmarkede konfiguration (kontekstlængde, parallelisme, opstartsflag)
- API kompatibel med OpenAI klar til brug – pejl din eksisterende SDK mod dit private endpoint
- Helt privat inferens — dine prompts og data forlader aldrig din egen server
- Tier-III (NL/FR) & ISO 27001 (DE) EU-datacentre 🇪🇺, overholdelse af GDPR med énkliks-DPO/DSA
- Fuld root-adgang via SSH — juster, skift modeller eller installer ekstra AI-programmer ved siden af vLLM
- Professionelt testede GPU-drivere og seneste CUDA — ingen problemer med driverversioner
- 100 % ren køretids-GPU ydeevne – de tokens/sec du ser i benchmark er præcis det, du får
- Gratis SSL 🔒 på din endpoint (HTTPS & WSS) plus en tilpasselig netværksniveau-brandmur
- Persisterende lagring med pauser/fryse — bevar din model og vægte, standser betalingen når den er inaktiv
- 🚀 Opgrader hardware når som helst — skift til en større GPU for større kontekst eller modeller uden geninstallation
Administreret GPU-server forinstalleret med vLLM
Trooper.AI giver dig en håndteret GPU-server forinstalleret med vLLM, klar til at servere ethvert åbent stort sprogmodel via en hurtig, OpenAI-kompatibel API. I stedet for at bruge timer på at vælge en GPU, installere CUDA-drivere, kompilere vLLM og justere startflag, vælger du blot et model ovenfor og klikker på Start. På få minutter får du en dedikeret EU-hospederet GPU-server med vLLM allerede kørende i den præcise konfiguration vi har benchmarket for det valgte model – herunder kontekstlængde, parallelisme og kommandolinjeargumenter inkluderet.
Hvorfor en forinstalleret vLLM-server?
vLLM er den branchenormerede højtydende inference engine, men at få det klar til produktion kan være besværligt: at matche driver og CUDA-versioner, vælge --max-num-batched-tokens, --max-num-seqs samt den rette kontekstvindue for din GPUs VRAM, og sikre sig, at modellen faktisk indlæses. Vores administrerede GPU-server med forinstalleret vLLM fjerner dette arbejde. Alle konfigurationsmuligheder på denne side stammer direkte fra automatiserede benchmarktests på den egentlige hardware, så serveren du deplojer opfører sig præcis som testkørslen – ingen gætning.
Privat, EU-hospiteret og din egen
Hver server kører på dedikerede bare-metal-GPU'er i ISO/IEC 27001-certificerede og GDPR-overholdende tyske datacentre. Du får fuld root-SSH-adgang, en vedvarende maskine samt et privat endpoint – dine prompts og data forlader aldrig din server. Da det er en hel GPU-server (ikke delt inferens), kan du også installere yderligere AI-programmer, finjustere eller køre billede- og lydmodeller sammen med dit LLM.
Transparente pris-præstation
For hver model viser vi den GPU med bedst pris pr. ydeevne, inklusive ærlige timeløn og månedlige priser. Du kan gennemgå reelle eksempler på svar per model via Vis responskvalitet før implementering, så du ved både hastigheden og kvaliteten af svaret du betaler for. Betal timer til eksperimenter eller måneder til produktion – en administreret GPU-server forinstalleret med vLLM, der skaleres efter dine behov.
Din egen private LLM-GPU-server
En dedikeret privat LLM-GPU-server giver dig hele maskinen: fuld root-adgang, en privat API-endpoint kompatibel med OpenAI, ubegrænsede forespørgsler til en fast forudbetalt pris samt friheden til at finjustere modellerne, skifte mellem dem eller køre billed- og lydopgaver parallelt med din LLM. Da GPU’en er din egen, bliver gennemstrømning og kontekstlængde forudsigelige, og dine prompts forlader aldrig din server – ideelt til stabil trafik og strenge krav om fortrolighed.
Vælg et model fra matricen ovenfor og klik på Start: inden for få minutter får du en EU-hospederet GPU-server med vLLM allerede kørende i den præcis benchmarkede konfiguration – inklusive kontekstlængde, parallelisme og opsætning af startflag. Betal timevis til eksperimentering eller månedligt til produktion, og opgrader når som helst til en større GPU for mere kapacitet eller modeller uden geninstallation.
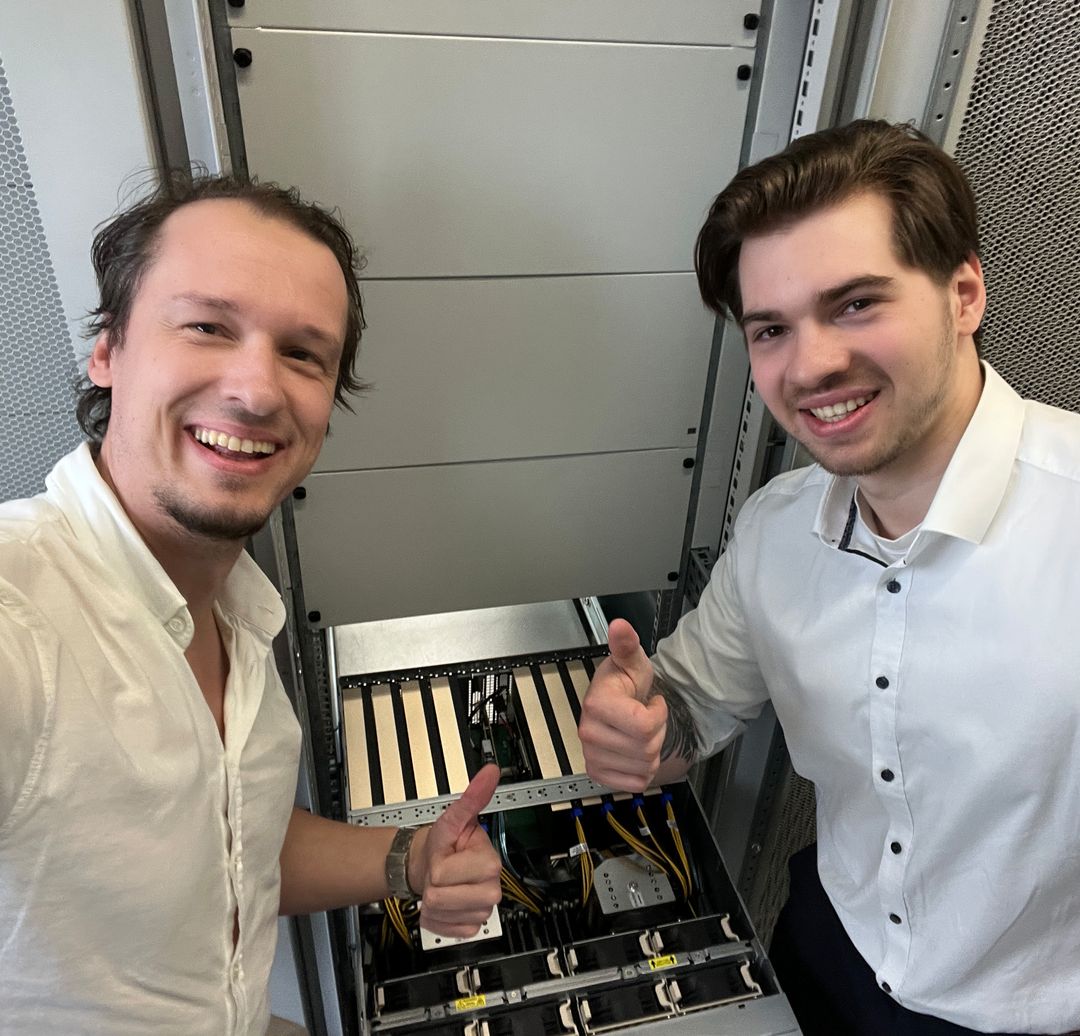
Pålidelig Hardware – Bygget af Eksperter
Bag hver privat LLM-GPU-server ligger der enterprise-class-hardware, som er genbrugt og vedligeholdes af vårt eget hold. Her ses Markus og Jaimie monterer et NVIDIA A100-cluster i en af vores ISO/IEC 27001-certificerede kolokationsdatacentre i Tyskland – samme type GPU-servere, du kan udplacere fra denne side. Vi omdanner højdeydelseselementer til optimerede inferens-rigs, hvilket forlænger hardwarenes levetid samtidig med at vi reducerer elektronisk affald. Vi sælger ikke videre tredjeparts-kapacitet; vi ejerskaber og driver selv vores egen hardware i kolokationsfaciliteter i Tyskland og Nederlandene, således at vi garanterer ydeevne, sikkerhed og dataresidens på alle lag i stakken.
Kompatibel med OpenAI Chat Completions API – Migrer din AI-stack på minutter
Din private vLLM-server udsætter et endpoint, der er 100 % kompatibelt med OpenAI Chat Completions API-formatet (/v1/chat/completions). Hvis din applikation allerede bruger OpenAI SDK – uanset om det er i Python, Node.js eller ethvert HTTP-klient – kræver det blot en ændring på én linje for at pege mod din egen server: opdater den grundlæggende URL og API-nøglen. Du får samme anmodnings- og responsskema samt fuld støtte til strømning, JSON-læg, funktioner kald og multimodale indgange. Ingen kodeomskrivning, ingen nye abstraktioner, ingen leverandørbindinger – din integration bliver portabel, og du beholder kontrol.
Leder du efter et alternativ til OpenAI API med europæisk hosting? En privat LLM-GPU-server giver dig tilsvarende funktioner som Chat Completions API med EU-dataresidens, en fast forudbetalt pris og fuld ejerskab af maskinen.
Fungerer med de Værktøjer Du Allerede Bruger
Fordi din server taler det samme sprog som OpenAI’s Chat Completions API, kan du integrere den i næsten ethvert AI-værktøj, IDE eller automatiseringsplatform – bare peg på din egen endpoints basURL og tilføj din nøgle.
… og mange flere – enhver app, agent eller SDK, der understøtter en OpenAI-kompatibel endpoint, fungerer lige ud af boksen.